Optisk tegngjenkjenning driver nå kvitteringsskanning, ID-verifisering, fakturaautomatisering, digitalisering av historiske arkiver og apper for pekepennbaserte notater. OCR-markedet forventes å nå 32.90 milliarder dollar innen 2030 med en årlig vekstrate på 14.8 % (Grand View Research, 2024), med intelligent tegngjenkjenning – håndskriftlesingsgrenen av OCR – som vokser raskest. Enten du bygger dokumentparsing, scenetekstgjenkjenning eller håndskrifttranskripsjon, setter OCR-datasettet du trener på nøyaktighetsgrensen din. Denne veiledningen dekker 22 gratis OCR-datasett med åpen kildekode – inkludert de beste håndskriftdatasettene – organisert etter brukstilfelle og oppdatert med de sterkeste utgivelsene frem til 2024.
Nøkkelfunksjoner
- OCR (Optical Character Recognition): teknologi som konverterer bilder av trykt tekst, scener eller håndskrevet tekst til maskinlesbare data.
- OCR-datasett er delt inn i fem grupper: dokument/skjema, scenetekst, siffer/tegn, håndskrift og flerspråklig.
- Dokument OCR-datasett fange strukturerte sider som skjemaer og kvitteringer; scenetekstdatasett fange tekst «i naturen».
- IAM, MNIST, ICDAR og SROIE er fortsatt de mest siterte OCR-referansepunktene på tvers av forskning.
- Lisensvilkårene varierer mye – bekreft hvert OCR-datasett før kommersiell opplæring.
Hva er OCR (Optical Character Recognition)?
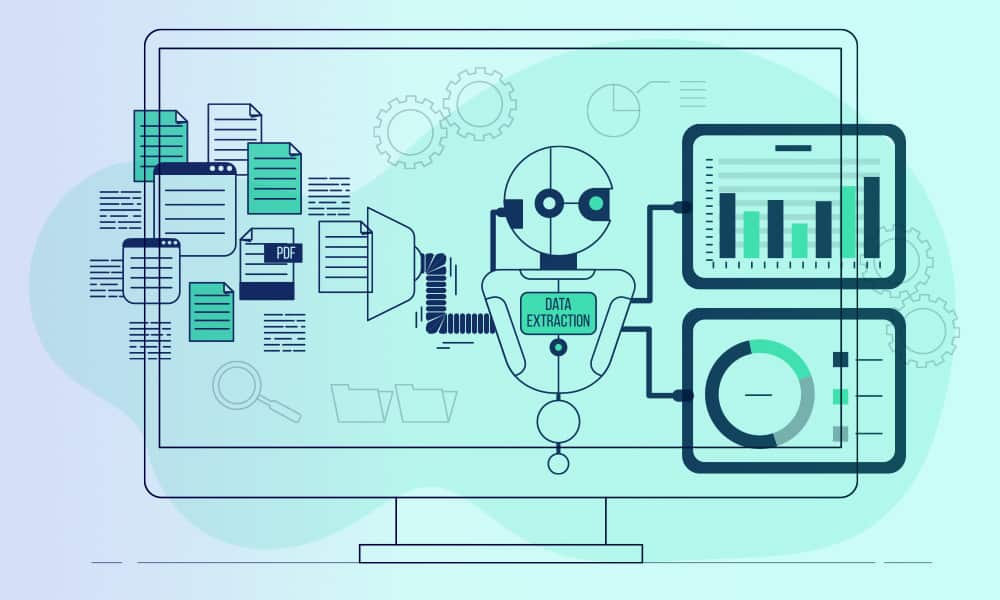
OCR er teknologi som konverterer ulike typer dokumenter, som skannede papirdokumenter, PDF-er eller bilder av tekst, til redigerbare og søkbare data. Det fungerer av:
- Analysere strukturen til tekst i et bilde
- Å bryte ned teksten i linjer og tegn
- Konvertering av disse visuelle tegnene til maskinlesbar tekst
Vanlige bruksområder inkluderer:
- Konvertering av skannede dokumenter til redigerbare tekstfiler
- Digitalisering av trykte bøker
- Trekker ut tekst fra bilder
- Konvertering av håndskrevne resepter til digital tekst
- Nummerskiltgjenkjenning
Hvordan velger du riktig OCR-datasett?
Valg av et OCR-datasett avhenger av fire faktorer: teksttype, opptaksmiljø, annotasjonsgranularitet og lisens. OCR for trykte dokumenter trenger andre treningsdata enn håndskrevet kursiv eller buet scenetekst. Dokumentdatasett passer til fakturaer, skjemaer og kvitteringer; scenetekstdatasett passer til skilt- og produktlesing; håndskriftdatasett passer til notater, manuskripter og penninntasting. Annoteringer på ord- og linjenivå støtter fulle OCR-pipelines, mens tegnnivåsett passer til klassifiseringsgrunnlinjer. Bekreft alltid lisensvilkårene, siden noen OCR-datasett kun er for forskning eller krever registrering.
Hva er de beste OCR-datasettene for dokumenter og skjemaer?
Dokument-OCR-datasett trener modeller til å analysere strukturerte sider som fakturaer, skjemaer, kvitteringer og ID-er. Disse driver automatisering av forretningsdokumenter og utvinning av nøkkelverdier.
- FUNSD — 199 kommenterte skannede skjemaer med støyende, virkelighetsnært utseende. Standardmålestokken for skjemaforståelse og nøkkelverdiutvinning.
- SROIE — ICDAR 2019-datasett med skannede kvitteringer på omtrent 1,000 kvitteringer, som støtter tekstdeteksjon, gjenkjenning og informasjonsutvinning i ett enkelt sett.
- LEDNING – Et konsolidert kvitteringsdatasett bygget for parsing etter OCR, med omfattende feltnivåetiketter for automatisering av fakturaer og kvitteringer.
- XFUND — Flerspråklig utvidelse av FUNSD som dekker sju språk (tysk, spansk, fransk, italiensk, japansk, portugisisk, kinesisk) med 199 sider hver. Ideell for flerspråklig dokument-AI.
- DDI-100 – Rundt 100 000 forvrengte dokumentbilder for deteksjon og gjenkjenning under reell forringelse som skjevhet, uskarphet og støy.
Hva er de beste OCR-datasettene for scenetekst?
Scenetekst-OCR-datasett trener modeller til å lese tekst i naturlige bilder som skilt, produkter og gatescener. Disse er viktige for OCR i naturen der bakgrunner er uoversiktlige.
- ICDAR Robust lesing – Referansefamilien bak det meste av scenetekstforskning, inkludert utfordringene med fokusert og tilfeldig scenetekst med avgrensningsbokser og transkripsjoner på ordnivå.
- COCO-tekst — Storskala scenetekstannoteringer lagt lagvis på MS-COCO-bilder. Sterk for tekstgjenkjenning i stor skala i naturlige scener.
- Totaltekst – Spesialiserer seg på buet og vilkårlig orientert tekst, et kjent svakt punkt for eldre OCR-modeller.
- SVT (Street View-tekst) — Word-bilder hentet fra Google Street View, ofte lav oppløsning og høy variasjon. Tilgjengelig via Papers med Code-speile.
- Hertekst — Hierarkisk annotering fra avsnitt til linje til ord, som dekker både håndskrevet og trykt scenetekst. Nyttig for layoutbevisst OCR.
Hva er de beste OCR-datasettene for sifre og tegn?
Datasett med OCR for sifre og tegn trener modeller til å gjenkjenne individuelle symboler i kontrollerte omgivelser. Dette er standard utgangspunkt for klassifiseringsgrunnlinjer.
- MNIST — 70 000 håndskrevne sifferbilder i gråtoner. Den raskeste grunnlinjen for validering av en sifferklassifikator.
- EMNIST — Utvider MNIST med 814 255 håndskrevne bokstaver og sifre hentet fra NIST Special Database 19.
- SVHN (husnummer i gatevisning) – Over 600 000 sifferbilder fra husnumre i den virkelige verden. Et praktisk steg opp fra MNIST for støyende forhold.
- Tegn74K — 74 107 bilder som dekker engelske og kannadaske tegn fra naturlige bilder og datafonter.
- NIST spesialdatabase 19 — 810 000+ håndtrykte figurbilder fra 3,600 forfattere. Kilden mange engelske OCR-referansetester er hentet fra.
Hva er de beste håndskriftdatasettene for OCR?
Håndskriftdatasett trener OCR-modeller til å lese kursiv, trykt og historisk håndskrevet tekst. De sterkeste åpne håndskriftdatasettene er fortsatt de mest siterte referansepunktene for håndskrevet tekstgjenkjenning (HTR).
- IAM-håndskriftdatabase — Gullstandarden for engelsk håndskrift, med 13 353 tekstlinjer fra 657 forfattere. Fortsatt det mest siterte håndskriftdatasettet i OCR-forskning fra 2024–2025.
- IAM-OnDB — Den nettbaserte pennestrøksversjonen av IAM, som fanger opp banedata. Det kanoniske håndskriftdatasettet for gjenkjenning av penner og nettbrett.
- Bentham-papirene — Transkriberte historiske engelske manuskripter fra filosofen Jeremy Bentham. Den ledende referansen for historisk håndskrift OCR, tilgjengelig via Transkribus.
- GNHK (GoodNotes håndskriftsamling) — Et datasett fra 2021 med ubegrensede, virkelige, engelske håndskrevne notater. Nærmere rotete produksjonsdata enn ren IAM på laboratoriet.
Hva er de beste flerspråklige og ikke-latinske OCR-datasettene?
Flerspråklige OCR-datasett trener modeller på skrifttyper utover engelsk, inkludert kinesisk, arabisk og matematisk notasjon. Disse er viktige for global dokument- og håndskriftgjenkjenning.
- CASIA-HWDB – Standard kinesisk OCR-referanseindeks, med 1.17 millioner håndskrevne tegnprøver fra 1,020 forfattere.
- KHATT — 1,000 arabiske håndskrevne skjemaer fra 1,000 forskjellige forfattere, skannet i flere oppløsninger. Det mest omfattende åpne arabiske OCR-datasettet.
- CROHME — Konkurranse om gjenkjenning av håndskrevne matematiske uttrykk på nett: 10 000+ uttrykk på tvers av 101+ matematiske symboler, i både online og offline varianter. Nødvendig for håndskrevne ligninger med OCR.
Hva er de vanlige fallgruvene når man bruker gratis OCR-datasett?
Tre fallgruver fanger de fleste lag.
Domeneavvik: Opplæring på ren IAM eller COCO-Text og distribusjon på krøllete fakturaer garanterer dårlig nøyaktighet.
Lisensblindhet: flere scenetekst- og historiske OCR-datasett er kun for forskning eller krever registrering før kommersiell bruk.
Annotasjonshull: Mange OCR-datasett mangler layoutmetadataene, avgrensningsboksene på linjenivå eller feltetikettene som produksjonssystemer trenger.
Se for deg et mellomstort logistikkfirma som automatiserer lesing av fraktetiketter. Opplæring av offentlig scenetekst får dem til 80 % på benchmarks, men ekte etiketter med gjenskinn og bretter reduserer dem til 58 %. For å lukke dette gapet kreves målrettet dataannotering av 6,000 etikettbilder i domenet før lansering.
Fordeler og utfordringer med datasett med åpen kildekode
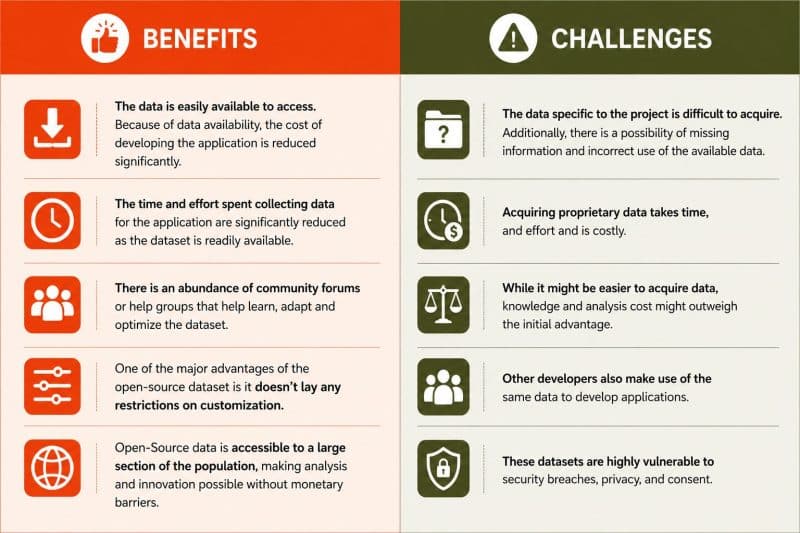
Bedrifter må sette fordelene og utfordringene opp mot hverandre for å forstå om de må velge gratis data for ML-applikasjonene sine.
Fordeler
- Dataene er lett tilgjengelige. På grunn av tilgjengeligheten av data reduseres kostnadene ved å utvikle applikasjonen betydelig.
- Tiden og kreftene brukt på å samle inn data for applikasjonen reduseres betydelig ettersom datasettet er lett tilgjengelig.
- Det er en overflod av fellesskapsfora eller hjelpegrupper som hjelper til med å lære, tilpasse og optimalisere datasettet.
- En av de største fordelene med åpen kildekode-datasettet er at det ikke legger noen begrensninger på tilpasning.
- Åpen kildekode-data er tilgjengelig for en stor del av befolkningen, noe som gjør analyser og innovasjon mulig uten økonomiske barrierer.
Utfordringer
- Dataspesifikke for prosjektet er vanskelige å få tak i. I tillegg er det en mulighet for manglende informasjon og feil bruk av tilgjengelige data.
- Å skaffe proprietære data tar tid og krefter og er kostbart
- Selv om det kan være lettere å skaffe data, kan kunnskap og analysekostnad oppveie den første fordelen.
- Andre utviklere bruker også de samme dataene for å utvikle applikasjoner.
- Disse datasettene er svært sårbare for sikkerhetsbrudd, personvern og samtykke.
Hvordan støtter Shaip OCR- og håndskriftgjenkjenningsprosjekter?
Shaips OCR-opplæringsdatatjenester kombinerer kuratering av åpne datasett med tilpasset datainnsamling på tvers av over 60 språk, som spenner over trykte dokumenter, håndskrift, kvitteringer og ID-er. Shaips annoteringsarbeidsflyter legger til lagene som offentlige OCR-datasett mangler: avgrensningsbokser på linjenivå, etiketter på feltnivå, transkripsjonskvalitetskontroll og forfattermetadata.
Konklusjon
De 22 OCR-datasettene ovenfor gir deg et komplett åpen kildekode-fundament på tvers av dokument-, scenetekst-, siffer-, håndskrift- og flerspråklig gjenkjenning for 2026. Start med OCR-datasettet som samsvarer med teksttypen og opptaksmiljøet ditt, valider mot et begrenset utvalg av dine faktiske data, og budsjetter for tilpassede annotasjoner for å lukke domenegapet. Den kombinasjonen leveres raskere enn å bygge fra bunnen av.