Tenk deg å ansette en ny ansatt. Én kandidat er en «allsidig mann» – kan litt om alt, men ikke i dybden. Den andre har 10 års erfaring i akkurat din bransje. Hvem stoler du på med dine kritiske forretningsbeslutninger?
Det er forskjellen mellom generelle store språkmodeller ( LLM-er ) og domenespesifikke LLM-er . Mens generelle modeller som GPT-4 eller Gemini er brede og fleksible, er domenefokuserte LLM-er trent eller finjustert for et bestemt felt – som medisin, jus, finans eller ingeniørfag.
I dette innlegget skal vi utforske hva domenespesifikke LLM-er er, fremheve eksempler fra den virkelige verden, diskutere hvordan man bygger dem, og dekke både fordelene og begrensningene deres.
Hva er domenespesifikke LLM-er?
En domenespesifikk LLM er en AI-modell som er optimalisert for å utmerke seg i et smalt, spesialisert område i stedet for generell språkforståelse. Disse modellene lages ofte ved å finjustere store grunnleggende modeller med nøye kuraterte datasett fra måldomenet.
👉 Tenk på en sveitsisk lommekniv kontra en skalpell . En generell LLM kan håndtere mange oppgaver rimelig bra (som den sveitsiske lommekniven). Men en domenespesifikk LLM er skarp, presis og bygget for spesialiserte jobber (som skalpellen).
Eksempler på domenespesifikke LLM-er
Domenespesialiserte modeller skaper allerede bølger på tvers av bransjer:
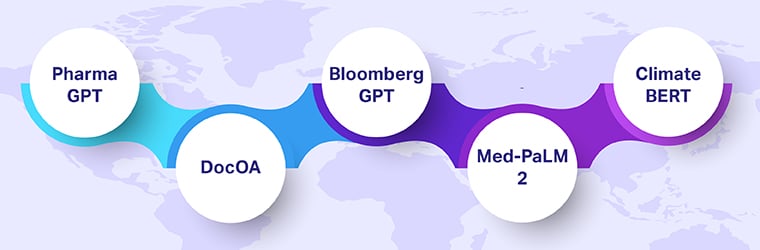
- PharmaGPT – En modell fokusert på biofarmasi og legemiddelutvikling. I følge nyere forskning (arXiv:2406.18045) viser den sterkere nøyaktighet på biomedisinske oppgaver samtidig som de bruker færre ressurser enn GPT-4.
- DocOA – En klinisk modell skreddersydd for slitasjegikt. Referansemodellen ble brukt i 2024 (arXiv:2401.12998), og den presterte bedre enn generelle LLM-er på spesialiserte medisinske resonneringsoppgaver.
- BloombergGPT – Bygget for finansmarkeder, trent på en blanding av offentlige finansielle dokumenter og proprietære datasett. Støtter investeringsanalyse, samsvar med regelverk og risikomodellering.
- Med-PaLM 2 – Denne helsefokuserte modellen, utviklet av Google DeepMind, oppnår toppmoderne nøyaktighet i svar på spørsmål om medisinske undersøkelser.
- KlimaBERT – En språkmodell trent på klimavitenskapelig litteratur, som hjelper forskere med å analysere bærekraftsrapporter og klimaavsløringer.
Hver av disse demonstrerer hvordan dyp spesialisering kan utkonkurrere generelle giganter i målrettede sammenhenger.
Fordeler med domenespesifikke LLM-er
Hvorfor haster bedrifter med å bygge sine egne domene-LLM-er? Flere viktige fordeler skiller seg ut:
Hvordan bygge en domenespesifikk LLM
Det finnes ingen universalløsning, men prosessen involverer vanligvis disse viktige trinnene:
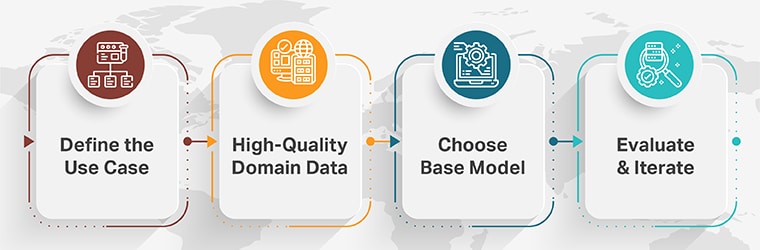
1. Definer brukstilfellet
Identifiser om målet er kundestøtte, samsvarsovervåking, legemiddelutvikling, juridisk analyse eller en annen domenespesifikk oppgave.
2. Kurater domenedata av høy kvalitet
Samle kommenterte datasett fra din bransje. Kvalitet er viktigere enn kvantitet her: et mindre datasett med høy kvalitet yter ofte bedre enn et stort, men støyende et.
3. Velg en basismodell
Start med en generell grunnleggende modell (som LLaMA, Mistral eller GPT-4) og tilpass den for domenet.
- FinjusteringOpplæring på domenespesifikke data for å justere vekter.
- Retrieval-Augmented Generation (RAG)Koble modellen til en kunnskapsbase for sanntids forankring.
- Små LLM-er (SLM-er)Trening av kompakte modeller som er effektive, men svært spesialiserte.
4. Evaluer og iterer
Sammenlign med generelle LLM-er for å sikre økt nøyaktighet. Spor hallusinasjonsrater, latens og samsvarsmålinger.
Domenespesifikke vs. generelle LLM-er
Hvordan står domenespesialiserte modeller seg mot sine generelle motparter? La oss sammenligne: