I kappløpet om å utvikle banebrytende AI-modeller står organisasjoner overfor en kritisk avgjørelse som kan avgjøre om de lykkes eller ikke: hvordan de skal hente inn opplæringsdataene sine. Selv om fristelsen til å bruke lett tilgjengelig nettskrapet og maskinoversatt innhold kan virke tiltalende, medfører denne tilnærmingen betydelige risikoer som kan undergrave både kvaliteten og integriteten til AI-systemer.
De skjulte farene ved hurtigreparerte dataløsninger
Tiltrekningen til nettskrapede data er ubestridelig. De er rikelig, tilsynelatende mangfoldige og virker kostnadseffektive ved første øyekast. En språklig prosjektleder advarer imidlertid: «Konsekvensene av å mate maskinlæringsalgoritmer med dårlig hentede data er alvorlige, spesielt når det gjelder språkmodeller. Feiltrinn i datanøyaktighet kan spre og forsterke skjevheter eller feilaktige fremstillinger.»
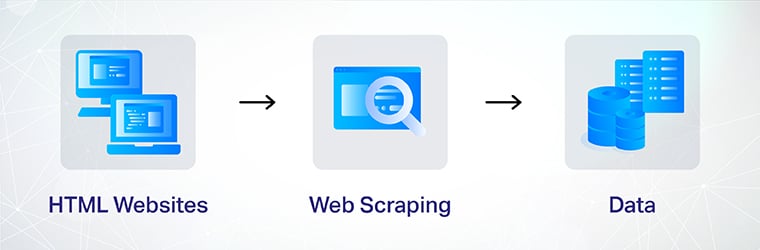
Denne advarselen gir gjenklang i dagens AI-landskap, hvor forskning viser at en sjokkerende mengde nettinnhold er maskinoversatt, noe som skaper en tilbakekoblingssløyfe av feil som forverres når den brukes til opplæring. Implikasjonene strekker seg langt utover enkle oversettelsesfeil – de rammer kjernen av AIs evne til å forstå og betjene mangfoldige globale befolkninger.
Kvalitetskrisen i AI-opplæringsdata
Når organisasjoner bruker upassende datainnsamlingsmetoder, oppstår det flere kritiske problemer:
«I vår erfaring med å jobbe med globale bedrifter», deler en senior dataforsker fra et Fortune 500-selskap, «ble de innledende kostnadsbesparelsene fra nettskrapede data fullstendig oppveid av månedene som ble brukt på feilsøking og omskolering av modeller som produserte pinlige feil i produksjonen.»
Bygge tillit gjennom ansvarlig datainnsamling
Fordelen med mennesket i loopen
Etisk datainnsamling krever fundamentalt menneskelig ekspertise. I motsetning til automatiserte skrapeverktøy, bringer menneskelige annotatorer kulturell forståelse og kontekstuell bevissthet som maskiner rett og slett ikke kan gjenskape. Dette er spesielt viktig for konversasjonelle AI-applikasjoner der det å forstå subtile språklige signaler kan utgjøre forskjellen mellom en nyttig interaksjon og en frustrerende opplevelse.
Profesjonelle dataannoteringsteam gjennomgår grundig opplæring for å sikre at de:
- Forstå de spesifikke kravene til AI-modelltrening
- Gjenkjenne og bevare språklige nyanser
- Bruk konsistente merkingsstandarder på tvers av ulike innholdstyper
- Identifiser potensielle skjevheter før de kommer inn i opplæringsprosessen
Åpenhet som en konkurransefordel
Organisasjoner som prioriterer transparent datainnhenting får betydelige fordeler i markedet. I følge Gartners spådommer om AI-styring vil 80 % av bedriftene ha forbudt skygge-AI innen 2027, noe som gjør etisk datapraksis ikke bare tilrådelig, men obligatorisk.
Dette skiftet gjenspeiler økende bevissthet blant bedriftsledere om at riktige datainnsamlingsteknikker direkte påvirker:
- Modellytelse og nøyaktighet
- Brukerens tillit og adopsjonsrater
- Overholdelse av regelverk på tvers av jurisdiksjoner
- Langsiktig skalerbarhet av AI-initiativer
Beste praksis for etiske AI-opplæringsdata
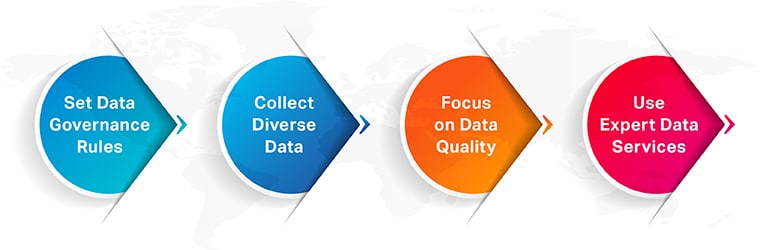
1. Etabler tydelige retningslinjer for datastyring
Organisasjoner må utvikle omfattende rammeverk som skisserer:
- Akseptable kilder for treningsdata
- Samtykkekrav og dokumentasjonsprosedyrer
- Kvalitetsstandarder og valideringsprosesser
- Retningslinjer for oppbevaring og sletting
2. Invester i mangfoldig datainnsamling
Ekte mangfold i treningsdata går utover språkvariasjon. Det omfatter:
- Geografisk representasjon i by- og landområder
- Demografisk inkludering på tvers av alder, kjønn og sosioøkonomiske grupper
- Kulturelle perspektiver fra ulike samfunn
- Domenespesifikk ekspertise for spesialiserte applikasjoner
For organisasjoner som utvikler AI-løsninger innen helsevesenet , kan dette bety å samarbeide med helsepersonell på tvers av ulike spesialiteter og regioner for å sikre klinisk nøyaktighet og relevans.
3. Prioriter kvalitet fremfor kvantitet
Selv om store datasett er viktige, gir datainnsamlingsmetoder av høy kvalitet bedre resultater. Et mindre datasett med nøye kuratert og nøyaktig merket innhold yter ofte bedre enn massive samlinger med tvilsom opprinnelse. Dette er spesielt tydelig i spesialiserte domener der presisjon er viktigere enn volum.
4. Utnytt profesjonelle datatjenester
I stedet for å forsøke å bygge en datainnsamlingsinfrastruktur fra bunnen av, lykkes mange organisasjoner med å samarbeide med spesialiserte leverandører som tilbyr etisk innhentede opplæringsdata . Disse partnerskapene gir:
- Tilgang til etablerte innsamlingsnettverk
- Overholdelse av internasjonale dataforskrifter
- Kvalitetssikring gjennom velprøvde prosesser
- Skalerbarhet uten at det går på bekostning av standarder
Veien videre: Bygge ansvarlig AI
Etter hvert som AI fortsetter å transformere bransjer, vil selskapene som lykkes være de som anerkjenner datakvalitet som et grunnleggende konkurransefortrinn. Ved å investere i etisk datainnhenting i dag, posisjonerer organisasjoner seg for bærekraftig vekst samtidig som de unngår fallgruvene som plager de som tar snarveier.
Budskapet er klart: i AI-utviklingens verden er det like viktig hvordan du henter dataene dine som algoritmene du bygger. Organisasjoner som omfavner ansvarlig datainnsamling, lager AI-systemer som ikke bare er mer nøyaktige, men også mer pålitelige, kulturelt bevisste og til syvende og sist mer verdifulle for brukerne sine.