En vellykket maskinlæringsmodell starter med treningsdata av høy kvalitet. Men et av de vanligste spørsmålene team stiller i starten av et AI-prosjekt er: hvor mye treningsdata er nok?
Det ærlige svaret er at det ikke finnes et fast tall som fungerer for alle prosjekter. Mengden data du trenger avhenger av oppgaven, modellens kompleksitet, antall klasser, datakvalitet, etikettnøyaktighet og ytelsesstandarden du ønsker å oppnå.
I praksis er den beste måten å estimere krav til opplæringsdata på å begynne med et representativt utvalg, trene på gradvis større delsett og måle når modellens ytelse begynner å flate ut. Dette hjelper team med å ta informerte beslutninger om kostnader, tidslinje, annoteringsinnsats og forventede resultater.
I denne bloggen bryter vi ned hovedfaktorene som påvirker mengden treningsdata, forklarer hvordan man estimerer krav i praksis, og viser hva man skal gjøre når man trenger mer data uten å forsinke AI-veikartet.
Hvorfor treningsdata er viktige
Treningsdata er grunnlaget for alle maskinlæringsystemer. Uansett hvor avansert algoritmen er, kan den bare lære mønstre som finnes i dataene som brukes til å trene den. Hvis dataene er ufullstendige, partiske, støyende eller for begrensede, vil modellen ha problemer med å generalisere i den virkelige verden.
Sterke treningsdata hjelper team:
- forbedre modellens nøyaktighet
- redusere skjevheter og blindsoner
- estimere prosjektkostnader og gjennomførbarhet mer nøyaktig
- redusere omarbeid under modelliterasjon
- bygge mer pålitelige validerings- og testrørledninger
Dette er grunnen til at datainnsamling, rengjøring, merking og validering ofte tar opp den største delen av arbeidet i AI-prosjekter. Hvis dataene er svake, vil også prediksjonene være svake.
Det finnes ikke noe universelt tall – men det finnes en praktisk måte å estimere det på
Mange artikler prøver å svare på dette spørsmålet med et enkelt tall. Det er sjelden nyttig.
En modell for enkel binær klassifisering kan fungere bra med et relativt lite datasett, mens en finjustering av arbeidsflyten for en stor språkmodell eller et datasynssystem for kanttilfeller kan kreve betydelig flere eksempler. Det bedre spørsmålet er ikke «hva er det magiske tallet?», men:
Hva er minimumsmengden representative treningsdata av høy kvalitet som trengs for å nå målytelsen for dette brukstilfellet?
En praktisk måte å svare på dette på er å bruke læringskurver: tren modellen på økende datamengder og observer hvor mye ytelsen forbedres med hvert trinn. Når forbedringen begynner å flate ut, har du et mye tydeligere signal om hvorvidt det er verdt investeringen å samle inn mer data. Denne tilnærmingen anbefales ofte i praktiske ML-arbeidsflyter.
7 faktorer som avgjør hvor mye treningsdata du trenger
1. Modelltype: Klassisk ML vs. dyp læring
Modelltypen har stor innvirkning på datakravene. Klassiske maskinlæringsmodeller som logistisk regresjon, beslutningstrær eller gradientforsterkning kan ofte fungere bra på mindre strukturerte datasett, spesielt når funksjonene er godt konstruert.
Dyp læringsmodeller krever generelt mer data fordi de lærer funksjoner automatisk og inneholder mange flere parametere. For bilde-, lyd- og språkoppgaver drar dyp læringsmodeller vanligvis betydelig nytte av ekstra datavolum og -mangfold.
2. Veiledet vs. uveiledet læring
Veiledet læring krever merkede data, som ofte er vanskeligere og dyrere å samle inn. Hvis modellen din trenger mennesker til å kommentere bilder, transkribere lyd, merke enheter eller klassifisere dokumenter, må datakravet ta hensyn til både mengde og merkingsinnsats.
Uovervåket læring krever ikke merkede data, men den drar fortsatt nytte av store, representative datasett. Selv uten merkelapper trenger modellen nok dekning til å oppdage meningsfulle mønstre og strukturer.
3. Oppgavekompleksitet og antall klasser
En enkel binær klassifiseringsoppgave er svært forskjellig fra et medisinsk bildebehandlingsproblem med flere klasser eller et flerspråklig talegjenkjenningssystem.
Etter hvert som oppgavekompleksiteten øker, øker vanligvis kravene til treningsdata fordi modellen må lære:
- flere klasser
- finere skille mellom kategorier
- flere kanttilfeller
- mer kontekstuell variasjon
For eksempel er det mye enklere å skille mellom «katt» og «hund» enn å identifisere dusinvis av visuelt like produktdefekter på tvers av lysforhold, kameravinkler og bakgrunner.
4. Datakvalitet og etikettnøyaktighet
Mer data er ikke alltid bedre hvis kvaliteten er dårlig.
Et mindre datasett med nøyaktige etiketter, balansert representasjon og konsistent formatering kan yte bedre enn et større, men støyende datasett. Etiketter av lav kvalitet, dupliserte poster, svake klassedefinisjoner, manglende metadata og inkonsistente annoteringsretningslinjer reduserer alle modellens ytelse.
Før de samler inn mer data, bør teamene spørre:
- Er etikettene konsistente?
- Dekker vi alle viktige brukerscenarioer?
- Er dataene representative for produksjonsforholdene?
- Er tog-, validerings- og testsett riktig atskilt?
For mange prosjekter gir forbedring av datakvaliteten raskere gevinster enn bare å øke datavolumet.
5. Mangfold, dekning og klassebalanse
En modell bør lære av den virkelige variasjonen den vil møte etter utrulling. Det betyr at datasettet bør gjenspeile ulike scenarier, brukergrupper, enhetstyper, aksenter, miljøer, dokumentformater, bildeforhold og kanttilfeller.
Hvis én klasse eller et segment er underrepresentert, kan modellen virke nøyaktig totalt sett, men mislykkes kraftig på kritiske undergrupper. Dette er grunnen til at mangfold og klassebalanse er like viktig som rå størrelse.
I mange tilfeller er spørsmålet ikke «Har vi nok data?», men «Har vi nok av de riktige dataene?»
6. Overfør læring og forhåndstrente modeller
Hvis du starter fra en forhåndstrent modell, kan det hende du trenger langt mindre oppgavespesifikke data enn om du trener fra bunnen av.
Dette gjelder spesielt for:
- bildeklassifisering ved hjelp av synsryggraden
- NLP-oppgaver ved bruk av transformatorbaserte modeller
- talemodeller tilpasset en ny aksent eller et nytt domene
- arbeidsflyter for domenetilpasning
Overføringslæring lar team gjenbruke kunnskap lært på store eksisterende datasett, noe som kan redusere annoteringsbyrden dramatisk. Den opprinnelige artikkelen dekket allerede dette godt; den bør beholdes, men med tydeligere eksempler.
7. Valideringsstrategi og måloppnåelse
Mengden data du trenger avhenger også av hvor god modellen må være.
En prototype kan fungere med beskjedne datamengder. En produksjonsmodell innen helsevesen, finans, forsikring, bilindustri eller miljøer med høy compliance-tunghet vil kreve sterkere dekning, renere etiketter, bedre validering og mer pålitelig ytelse på tvers av kanttilfeller. Jo strengere den akseptable feilraten er, desto mer robust må datasettet ditt være.
Hvordan estimere krav til opplæringsdata i praksis
I stedet for å gjette, bruk en strukturert estimeringsprosess.
Trinn 1: Start med et representativt pilotdatasett
Samle et mindre, men representativt utvalg av problemområdet. Inkluder viktige klasser, formater, brukertyper og variasjoner fra den virkelige verden.
Trinn 2: Del dataene riktig
Opprett separate sett for trening, validering og testing. Sørg for at testsettet gjenspeiler produksjonsforholdene og aldri brukes under trening.
Trinn 3: Tren på gradvis større prøver
Tren modellen ved å bruke økende deler av datasettet, for eksempel 10 %, 20 %, 40 %, 60 %, 80 % og 100 %.
Trinn 4: Tegn en læringskurve
Spor ytelsesmålinger som nøyaktighet, F1-poengsum, gjenkjenning, presisjon eller oppgavespesifikke kvalitetsmål etter hvert som datasettstørrelsen øker.
Trinn 5: Se etter platået
Hvis modellens ytelse forbedres kraftig med mer data, trenger du sannsynligvis mer. Hvis forbedringene flater ut, kan det hende at flaskehalsen ikke lenger er volum – det kan være etikettkvalitet, funksjonsdesign, modellvalg eller klasseubalanse.
Trinn 6: Gjennomgå ytelse på segmentnivå
Sjekk hvordan modellen presterer ikke bare totalt sett, men også på tvers av viktige klasser og kanttilfeller. En modell kan flate ut totalt sett, men fortsatt underprestere dårlig på minoritetssegmenter. Denne metoden gir interessentene et mer realistisk estimat av hvor mye tilleggsdata det er verdt å samle inn.
Hvordan vite når du har nok treningsdata
Du har sannsynligvis nok data når:
- Modellytelsen forbedres bare marginalt etter hvert som mer data legges til
- valideringsresultatene er stabile på tvers av flere kjøringer eller folder
- viktige klasser presterer akseptabelt, ikke bare majoritetsklassen
- Ytelsen holder på et rent, urørt testsett
- De resterende feilene skyldes mer støy eller tvetydighet på etiketten enn mangel på eksempler.
Du trenger sannsynligvis mer data når:
- læringskurven er fortsatt stigende
- sjeldne klasser presterer dårlig
- modellen mislykkes på vanlige variasjoner i den virkelige verden
- resultatene svinger mye mellom rundene
- Testytelsen faller kraftig sammenlignet med valideringsytelsen
Slik reduserer du kravene til opplæringsdata
Noen ganger er ikke utfordringen modelldesign – det er datamangel, budsjett eller tid til markedet. I slike tilfeller kan team redusere avhengigheten av enorme datavolumer med de riktige strategiene.
Dataforsterkning
Datautvidelse skaper nye treningseksempler fra eksisterende data. Innen datasyn kan dette inkludere beskjæring, rotering, snuing eller justering av lysstyrke. Innen NLP og tale må utvidelse være mer forsiktig, men kontrollerte transformasjoner kan fortsatt hjelpe.
Brukt riktig forbedrer augmentasjon robustheten og hjelper modeller med å generalisere bedre. Brukt dårlig kan det introdusere støy eller urealistiske eksempler.
Overfør læring
Overført læring lar deg tilpasse en eksisterende modell for en ny oppgave i stedet for å trene fra null. Dette er ofte en av de mest effektive måtene å redusere kravene til treningsdata på.
Forhåndsutdannede modeller
Forhåndstrente modeller som BERT-lignende NLP-modeller eller etablerte visjonsmodeller kan gi sterke utgangspunkt. I stedet for å lære alt fra bunnen av, starter modellen med nyttig forkunnskap.
Aktiv læring
Hvis merking er dyrt, kan aktiv læring bidra til å prioritere de mest informative eksemplene først. Dette forbedrer annoteringseffektiviteten og kan redusere antall etiketter som trengs for å oppnå nyttig ytelse.
Syntetiske data
Syntetiske data kan være nyttige når data fra den virkelige verden er knappe, sensitive eller vanskelige å samle inn, spesielt innen områder som helsevesen, finans, autonome systemer og edge-case-simulering. Men de bør supplere – ikke blindt erstatte – reelle, representative data.
Eksempler fra den virkelige verden på maskinlæringsprosjekter med minimale datasett
Selv om det kan høres umulig ut at noen ambisiøse maskinlæringsprosjekter kan utføres med minimale råvarer, er noen tilfeller forbløffende sanne. Forbered deg på å bli overrasket.
| Kaggle-rapport | Helsevesen | Klinisk onkologi |
| En Kaggle-undersøkelse viser at over 70 % av maskinlæringsprosjektene ble fullført med mindre enn 10,000 XNUMX prøver. | Med bare 500 bilder trente et MIT-team en modell for å oppdage diabetisk nevropati i medisinske bilder fra øyeskanninger. | For å fortsette eksemplet med helsetjenester, klarte et team fra Stanford University å utvikle en modell for å oppdage hudkreft med bare 1000 bilder. |
Gjør utdannede gjetninger
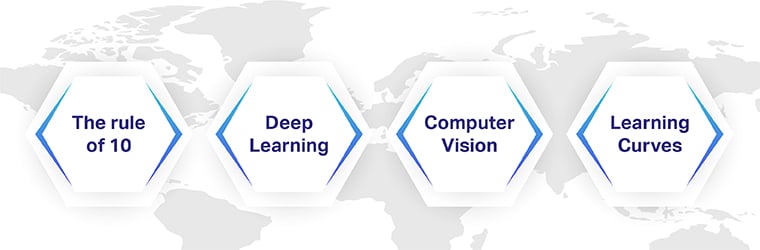
Det er ikke noe magisk tall angående minimumsmengde data som kreves, men det er noen få tommelfingerregler du kan bruke for å komme frem til et rasjonelt tall.
Regelen om 10
Som en tommelfingerregel bør antallet treningsdatasett som kreves være ti ganger mer enn hver modellparameter, også kalt frihetsgrader, for å utvikle en effektiv AI-modell. «10»-gangensreglene tar sikte på å begrense variasjonen og øke mangfoldet av data. Denne tommelfingerregelen kan derfor hjelpe deg med å komme i gang med prosjektet ditt ved å gi deg en grunnleggende idé om den nødvendige mengden datasett.
Dyp læring
Dyplæringsmetoder bidrar til å utvikle høykvalitetsmodeller hvis mer data leveres til systemet. Det er generelt akseptert at det å ha 5000 merkede bilder per kategori bør være nok til å lage en dyp læringsalgoritme som kan fungere på nivå med mennesker. For å utvikle eksepsjonelt komplekse modeller kreves det minst 10 millioner merkede varer.
Datamaskin syn
Hvis du bruker dyp læring for bildeklassifisering, er det enighet om at et datasett med 1000 merkede bilder for hver klasse er et rimelig antall.
Læringskurver
Læringskurver brukes til å demonstrere maskinlæringsalgoritmens ytelse mot datamengde. Ved å ha modellferdigheten på Y-aksen og opplæringsdatasettet på X-aksen, er det mulig å forstå hvordan størrelsen på dataene påvirker resultatet av prosjektet.
Kostnaden ved å ha for lite data
Når team trener på begrensede, smale eller partiske datasett, kan modellen virke lovende i utvikling, men mislykkes i produksjon.
For lite data kan føre til:
- overtilpassing
- svak generalisering
- ustabile spådommer
- dårlige resultater på minoritetsklasser
- høyere risiko for skjevhet
- mer iterasjonstid senere
Med andre ord blir begrensningene i treningsdataene dine ofte begrensningene til produktet ditt.
Hva du skal gjøre hvis du trenger flere datasett
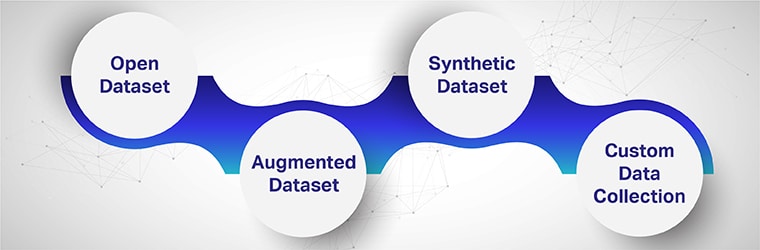
Når du identifiserer et datagap, er ikke løsningen alltid å «samle alt». Den smartere tilnærmingen er å utvide datasettet strategisk.
1. Bruk åpne datasett med omhu
Åpne datasett kan være nyttige for prototyping eller benchmarking, men de er ikke alltid egnet for produksjonsbruk. Team bør gjennomgå opprinnelse, samtykke, kvalitet, relevans og dekning før de stoler på dem.
2. Samle inn tilpassede data for ditt brukstilfelle
Hvis målmiljøet er svært spesifikt, er tilpasset datainnsamling ofte det beste alternativet. Dette gjelder spesielt for domenetunge arbeidsflyter som helsevesenets AI, konversasjonsbasert AI, datasyns-edge-tilfeller og flerspråklige systemer.
3. Forbedre eksisterende data gjennom annotering
Mange team har allerede rådata, men mangler struktur. Annotering, ommerking, taksonomiopprydding og kvalitetsgjennomgang kan frigjøre verdi raskere enn å samle inn helt nye datasett.
4. Rebalanser underrepresenterte klasser
Hvis ytelsen er svak på spesifikke kategorier, fokuser innsamling og merking på de hullene med stor innvirkning i stedet for å utvide hele datasettet jevnt.
5. Legg til syntetiske eller utvidede data der det er passende
Når reelle data er begrensede eller sensitive, kan syntetiske og utvidede data bidra til å forbedre dekningen – men de bør valideres nøye mot reelle fordelinger.
6. Samarbeid med en spesialisert datapartner
For team som bygger produksjons-AI i stor skala, kan et samarbeid med en leverandør som kan samle inn, lisensiere, annotere, validere og styre opplæringsdata av høy kvalitet redusere prosjektrisikoen betydelig og fremskynde utrullingen.
Final Thoughts
Det finnes ikke noe magisk tall for treningsdata i maskinlæring. Riktig mengde avhenger av brukstilfelle, modelltype, datakvalitet, klassemangfold, valideringsstrategi og målytelse.
Den mest effektive måten å estimere behovet for opplæringsdata på er å starte med et representativt utvalg, måle ytelse ved hjelp av læringskurver og utvide datasettet strategisk basert på hvor modellen fortsatt feiler.
For noen prosjekter kan et beskjedent datasett av høy kvalitet være nok. For andre, spesielt miljøer med høy innsats eller svært variable, avhenger suksess av store, nøye kuraterte og godt kommenterte datasett.
Det som betyr mest er ikke bare å ha mer data – men å ha de riktige dataene.
Har du et flott prosjekt i tankene, men venter på skreddersydde datasett for å trene modellene dine, eller sliter du med å få det rette resultatet fra prosjektet ditt? Vi tilbyr omfattende opplæringsdatasett for en rekke prosjektbehov. Utnytt potensialet til Shaip ved å snakke med en av våre dataforskere i dag, og få en forståelse av hvordan vi har levert høytytende datasett av høy kvalitet til kunder tidligere.