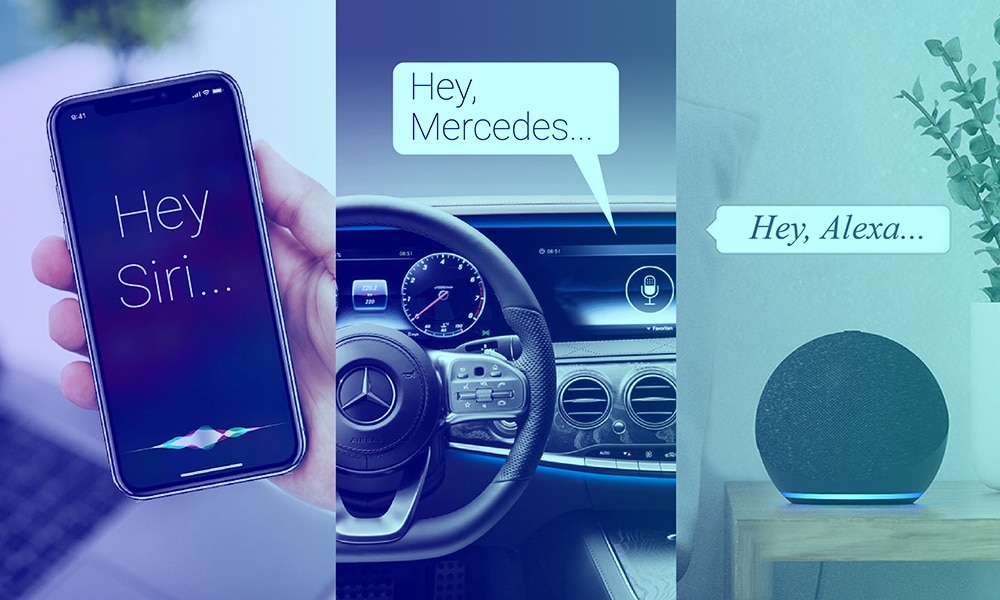
I dagens fartsfylte og teknologidrevne verden har samtalebaserte AI-applikasjoner som Alexa, Siri og Google Home blitt uunnværlige i hverdagen vår. De forenkler oppgaver, gir umiddelbare løsninger og forbedrer måten vi samhandler med maskiner på. Men bak den sømløse opplevelsen ligger en labyrint av utfordringer som utviklere står overfor når de bygger intelligente samtalesystemer.
Etter hvert som etterspørselen etter smartere, flerspråklige og emosjonelt intelligente chatassistenter vokser, er det viktig å forstå hindringene ved å lage disse verktøyene – og hvordan man kan overvinne dem effektivt. I denne veiledningen skal vi utforske de mest presserende datautfordringene innen samtalebasert AI og tilby handlingsrettede løsninger for å bygge AI-modeller som virkelig resonnerer med brukerne.
De vanligste datautfordringene i konversasjonsbasert AI
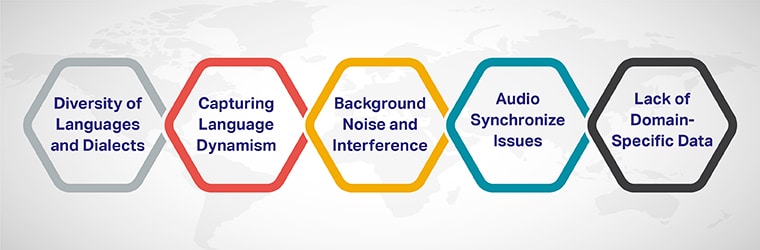
1. Mangfold av språk og dialekter
En av de største utfordringene innen konversasjonsbasert kunstig intelligens er det store mangfoldet av språk som snakkes rundt om i verden. Selv om omtrent 1.35 milliarder mennesker snakker engelsk enten som første- eller andrespråk, utgjør dette mindre enn 20 % av verdens befolkning. Det etterlater milliarder av potensielle brukere som kommuniserer på andre språk, ofte rike på unike dialekter, slang og kulturelle nyanser.
Løsningen:
For å bygge bro over dette gapet trenger bedrifter tilgang til enorme, flerspråklige datasett av høy kvalitet som ikke bare dekker store språk, men også regionale dialekter og språk. Å utnytte forhåndsannoterte taledatasett skreddersydd for globale markeder kan forbedre inkluderingen og allsidigheten til samtalemodeller for kunstig intelligens.
2. Fange språkdynamikk
Språk lever – de utvikler seg med tiden, innlemmer slang og reflekterer følelser. Denne dynamikken utgjør en utfordring for AI-modeller, som sliter med å tolke subtile nyanser som tone, sarkasme og følelser. Mennesker kommuniserer utover ord, og hvis man ikke klarer å fange opp denne «menneskelige faktoren», kan det føre til upersonlige eller irrelevante reaksjoner.
Løsningen:
Tren din AI med datasett som inkluderer eksempler fra den virkelige verden på emosjonelle, kontekstuelle og kulturelle variasjoner. Ved å innlemme emosjonelt intelligente AI-treningsdatasett sikrer du at samtaleassistenten din forstår den dypere konteksten bak brukerforespørsler, noe som resulterer i mer naturlige og meningsfulle interaksjoner.
3. Bakgrunnsstøy og interferens
Fra bjeffende hunder og dørklokker til overlappende samtaler, er lyd i den virkelige verden sjelden plettfri. Disse bakgrunnsstøyene forstyrrer ofte stemmegjenkjenningssystemer, noe som reduserer nøyaktigheten til samtale-AI. I tillegg, med flere stemmeassistenter som eksisterer samtidig i samme miljø, kan det være vanskelig å skille brukerkommandoer fra konkurrerende enheter.
Løsningen:
Avanserte støyfiltreringsalgoritmer kombinert med høykvalitets lyddatasett fra den virkelige verden kan hjelpe deg med å trene AI-en din til å identifisere og prioritere menneskelige kommandoer fremfor bakgrunnsstøy. Å designe robuste stemmegjenkjenningsmodeller som inkluderer ulike akustiske miljøer er avgjørende for å overvinne denne utfordringen.
4. Problemer med lydsynkronisering
Når man trener AI-verktøy ved hjelp av telefonsamtaler, kan det være problematisk å synkronisere lyd fra både den som ringer og agenten. Feiljusterte lyddata skaper hull i forståelsen av samtaleflyten, noe som fører til ineffektivitet i treningen av modellen.
Løsningen:
Invester i datasett som er forhåndssynkronisert og annotert for tokanals lyd. Dette sikrer at samtaler er nøyaktig justert og klare for trening, noe som reduserer manuelt arbeid og forbedrer modellens ytelse.
5. Mangel på domenespesifikke data
Konversasjonsbasert AI er ikke universell løsning. Selv om generelle chatboter fungerer bra i enkle oppgaver, klarer de ofte ikke å gi presise svar på bransjespesifikke spørsmål – det være seg innen helsevesen, finans eller bilindustrien.
Løsningen:
For å bygge bransjespesifikke AI-applikasjoner trenger du tilpassede datasett som gjenspeiler terminologien, prosessene og brukerforventningene til det domenet. For eksempel kan det å trene helse-chatboten din med kommenterte medisinske samtaler eller EHR-datasett forbedre nøyaktigheten og relevansen betydelig.
[Les også: AI-drevet telemedisin: Bruksområder, fordeler og utfordringer i den virkelige verden ]
Virkningen av datautfordringer på forbrukere
I motsetning til tekstbaserte søkemotorer som tilbyr flere alternativer, forventes det at Conversational AI skal levere et enkelt, nøyaktig svar. Når de underliggende datasettene er partiske eller ufullstendige, kan resultatene være misvisende, irrelevante eller til og med frustrerende for brukerne. Denne mangelen på presisjon reduserer ikke bare brukertilliten, men påvirker også merkevarens omdømme.
For bedrifter er innsatsen klar: bedre data fører til bedre kundeopplevelser . Å håndtere disse utfordringene i datainnsamlings- og modelltreningsfasene sikrer at din konversasjonsbaserte AI konsekvent leverer verdi til brukerne.
Slik overvinner du datautfordringer og bygger smartere AI
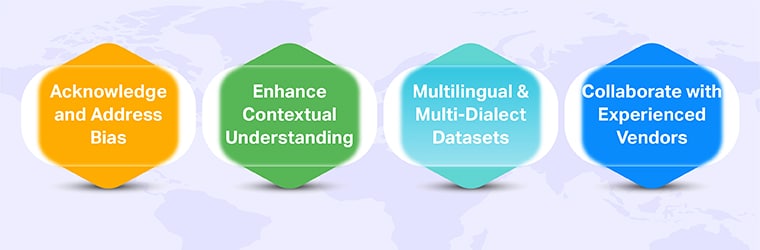
1. Anerkjenn og adresser skjevheter
Det første steget for å bygge bedre AI er å gjenkjenne tilstedeværelsen av skjevheter i datasett. Proaktiv introduksjon av strategier for å oppdage og redusere skjevheter – som tilbakemeldingsløkker for brukere og tilpassbare innstillinger – kan bidra til å forhindre skjeve resultater.
2. Forbedre kontekstuell forståelse
Det er avgjørende å trene modellen din til å forstå kontekstuelle samtaler. Dette kan oppnås ved å innlemme datasett som gjenspeiler virkelige interaksjonsmønstre, inkludert samtaler med flere talere og spontan dialog.
3. Invester i flerspråklige og flerdialektbaserte datasett
Å utvide språkdekningen med ulike datasett er nøkkelen til å nå et globalt publikum. Ved å samarbeide med dataleverandører som spesialiserer seg på flerspråklige konversasjonsbaserte AI-opplæringsdatasett , kan bedrifter skalere AI-løsningene sine for å imøtekomme ulike markeder.
4. Samarbeid med erfarne leverandører
Å samarbeide med en erfaren partner for konversasjonsbasert AI-datainnsamling kan effektivisere innsamlings- og annoteringsprosessen betydelig. Erfarne leverandører har ekspertise i å lage tilpassbare datasett av høy kvalitet som er skreddersydd til dine spesifikke behov. Dette reduserer ikke bare kostnadene, men akselererer også tiden det tar å få AI-løsningene dine på markedet.
[Les også: Fremveksten av AI-baserte stemmeassistenter for å forbedre kvaliteten på helsetjenester ]
Trender som former fremtiden for konversasjonsbasert AI
- Stemmebiometri: AI-systemer integrerer stemmebiometri for å forbedre sikkerhet og personalisering. Med biometriske datasett kan bedrifter lage AI-løsninger som gjenkjenner individuelle brukere basert på deres unike stemmemønstre.
- Multimodal AI: Neste generasjons samtalebasert AI kombinerer tekst, tale og visuelle inndata for å levere rikere og mer interaktive brukeropplevelser. Trener AI-modeller med multimodale datasett blir en prioritet for bedrifter som ønsker å ligge i forkant.
- Generativ AI for samtaler: Generative AI-modeller som ChatGPT revolusjonerer samtalesystemer. Innlemmer finjusterte generative AI-datasett kan gi chatassistenten din muligheten til å generere svar som føles mer menneskelige og tilpasningsdyktige.

Samarbeid med Shaip for nøyaktige samtalebaserte AI-datasett
Hos Shaip spesialiserer vi oss på å tilby skreddersydde datasett av høy kvalitet for konversasjonsbasert AI. Enten du bygger en flerspråklig chatbot, finjusterer en stemmeassistent eller designer en bransjespesifikk applikasjon, kan vår omfattende katalog med tale-, lyd- og tekstdatasett gjøre prosjektet ditt til en suksess.
Med ekspertise på over 65 språk og dialekter, hjelper Shaip bedrifter med å overvinne datautfordringer og skape AI-løsninger som er inkluderende, intelligente og effektive. La oss hjelpe deg med å frigjøre det fulle potensialet til konversasjonsbasert AI.