Store språkmodeller (LLM) som GPT-4 og Llama 3 har påvirket AI-landskapet og utført underverker, alt fra kundeservice til innholdsgenerering. Men å tilpasse disse modellene til spesifikke behov betyr vanligvis å velge mellom to kraftige teknikker: Retrieval-Augmented Generation (RAG) og finjustering.
Mens begge disse tilnærmingene forbedrer LLM-er, er de artikulert mot forskjellige mål og er vellykkede i forskjellige situasjoner. La oss studere disse to metodene i detalj fordeler og ulemper og hvordan man kan velge en for deres behov.
Retrieval-Augmented Generation (RAG) – Hva er det?
RAG er en tilnærming som synergiserer de generative evnene til LLM-er med gjenfinning av kontekstuelt presise svar. I stedet for bare å bruke kunnskapen den testet på, henter RAG relevant informasjon via eksterne databaser eller kunnskapsarkiv for å integrere informasjonen i svargenereringsprosessen.
Hvordan RAG fungerer
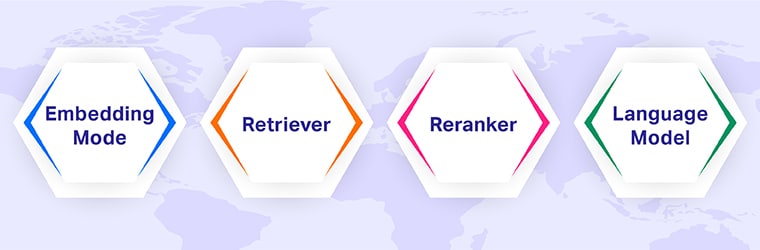
- Innebyggingsmodell: Bygger inn både dokumentene og spørringene i vektorrommet for å gjøre en sammenligning mer effektiv.
- retriever: Ser inn i en kunnskapsbase via innebygginger for å hente relevante dokumenter.
- Reranker: Scorer de hentede dokumentene etter hvor relevante de er.
- Språkmodell: Slår sammen hentede data med en brukers spørringer til ett svar.
Fordeler med RAG
- Dynamiske kunnskapsoppgraderinger: Gir et effektivt treff av informasjon med oppdateringsprosessene sterkt redusert gjennom prosessen med modellomskolering.
- Reduksjon av hallusinasjoner: Ved å begrunne svar på ekstern kunnskap, minimerer RAG faktiske unøyaktigheter.
- skalerbarhet: Kan enkelt integreres i store, varierte datasett og gir dermed mulighetene for nyttige åpne og dynamiske oppgaver, som kundeagenter og nyhetsoppsummering.
Begrensninger av RAG
- Ventetid: Selve oppmerksomheten i informasjonsutvinning, forsinker utdatatiden, noe som resulterer i høyere latens og gjør den irrelevant for sanntidsarbeidsmiljøer.
- Kvaliteten på kunnskapsbasen: Pålitelighet i gjenfinning og relevans av ekstern kunnskap blir viktig ettersom svar utelukkende avhenger av disse kildene.
Finjustering - hva er det?
Finjustering er en prosess for å omskolere en forhåndstrent LLM på et spesifikt domenedatasett i forberedelsen av spesialisert oppgaveutførelse, slik at modellen fullt ut kan forstå nyanserte mønstre som eksisterer innenfor grensen av en viss kontekst.
Hvordan finjustering fungerer
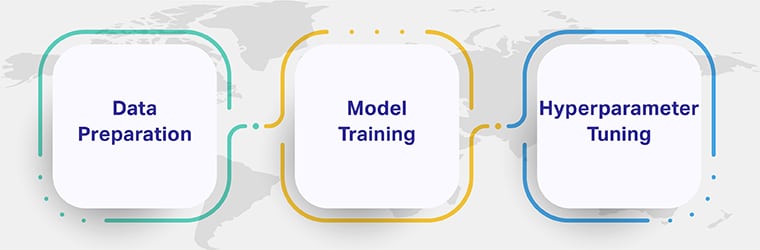
- Dataforberedelse: Oppgavespesifikke datasett må renses og settes til side i delsett for opplæring, validering og testing.
- Modellopplæring: LLM må trene på dette datasettet med metoder som inkluderer tilbakepropagasjon og gradientnedstigning.
- Innhold av hyperparameterinnstilling: Gir finjustering av noen få av de kritiske hyperparameterinnholdet, som batchstørrelse og læringshastighet, blant annet.
Fordeler med finjustering
- tilpasning: Tillater autoriteter over modellens handlinger, tone og stil i utdata.
- Effektivitet i inferens: Når en LLM har blitt finjustert, gir den raske svar uten noen ekstern gjenfinningsprosess.
- Spesialiserte ferdigheter: Best egnet for applikasjoner som krever kvalitet og nøyaktighet på tvers av velforståtte domener, for eksempel frysing, medisinske evalueringer og kontraktsanalyse.
Ulemper med finjustering
- Ressursintensive: Krever både stor datakraft og merket data av tilstrekkelig høy kvalitet.
- Katastrofal glemsel: Finjustering har en tendens til å overskrive tidligere ervervet generisk kunnskap og dermed begrense potensialet til å imøtekomme nye oppgaver.
- Statisk kunnskapsbase: Når opplæringen er fullført, forblir kunnskapen intakt med mindre den læres på nytt på ytterligere nye data.
Viktige forskjeller mellom RAG og finjustering
| Trekk | Gjenvinningsutvidet generasjon (FILLE) | Finjustering |
|---|---|---|
| Kunnskapskilde | Eksterne databaser (dynamisk) | Internalisert under trening (statisk) |
| Tilpasningsevne til nye data | Høy; oppdateringer via eksterne kilder | Lav; krever omskolering |
| Ventetid | Høyere på grunn av gjenfinningstrinn | Lav; generering av direkte respons |
| Tilpasning | Begrenset; er avhengig av eksterne data | Høy; skreddersydd for spesifikke oppgaver |
| skalerbarhet | Kan skaleres enkelt med store datasett | Ressurskrevende i skala |
| Bruk eksempler på saker | Spørsmål og svar i sanntid, faktasjekking | Sentimentanalyse, domenespesifikke oppgaver |