Talegjenkjenning er en teknologi som identifiserer og autentiserer en person basert på de unike egenskapene til stemmen deres, mens dens nære søsken, talegjenkjenning, konverterer talte ord til tekst eller kommandoer. Sammen driver de alt fra smarte høyttalere og kontroller i bilen til banksikkerhet og klinisk dokumentasjon. Det globale markedet for tale- og talegjenkjenning ble verdsatt til 20.25 milliarder dollar i 2023 og forventes å nå 53.67 milliarder dollar innen 2030, med en vekstrate på 14.6 % (Grand View Research, 2024) – og talegjenkjenning er det raskest voksende funksjonssegmentet innenfor dette (Grand View Research, 2024).
Denne veiledningen forklarer hvordan talegjenkjenning fungerer, hvor den brukes, fordeler og begrensninger, og endringene i 2026 som omformer feltet.
Nøkkelfunksjoner
- Stemmegjenkjenning identifiserer hvem som snakker, mens talegjenkjenning forstår hva som blir sagt.
- Systemer analyserer tonehøyde, frekvens, aksent og kadens for å bygge et unikt stemmeavtrykk.
- Toppapplikasjoner: sikkerhet og biometri, stemmeaktiverte enheter, kundeservice, helsevesen og bilindustri.
- Nøyaktighet avhenger i stor grad av mangfoldige, godt merkede treningsdata på tvers av aksenter og språk. Å hente inn disse i stor skala er der det er klart til bruk. taledatasett spare teamene for måneder med innsamling.
- Trendene i 2026 inkluderer tale-til-tale AI-modeller, prosessering på enheter og forsvar mot dypfalsk tale.
Markedsstørrelse: På mindre enn 20 år har talegjenkjenningsteknologi vokst fenomenalt. Men hva bringer fremtiden? I 2020 var det globale markedet for talegjenkjenningsteknologi omtrent 10.7 milliarder dollar. Det er anslått at det vil skyte i været til 27.16 milliarder dollar innen 2026, med en årlig vekstrate på 16.8 % fra 2021 til 2026.
Hva er talegjenkjenningsteknologi?
Feltet kan spores tilbake til systemer på 1950-tallet som bare kunne gjenkjenne en håndfull sifre. Statistiske modeller og senere dyp læring forvandlet disse tidlige eksperimentene til de alltid lyttende assistentene og sikre stemmegodkjenningssystemene som brukes av milliarder av mennesker i dag.
Stemmegjenkjenning – fordeler og ulemper
Hvordan fungerer stemmegjenkjenning?
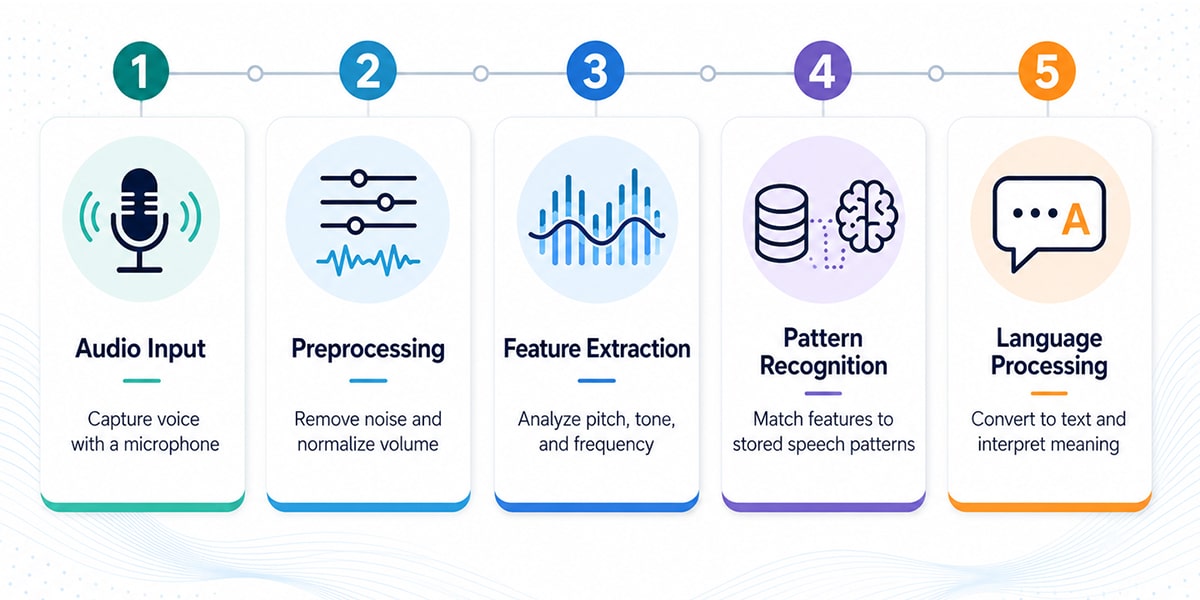
Lydinngang : Prosessen begynner med å ta opp lydinngangen ved hjelp av en mikrofon.
Forbehandling : Lydsignalet renses opp ved å fjerne støy og normalisere volumet.
Funksjonsutvinning : Systemet analyserer lyden for å trekke ut viktige funksjoner som tonehøyde, tone og frekvens.
Mønstergjenkjenning : De ekstraherte funksjonene sammenlignes med kjente talemønstre lagret i en database.
Språkbehandling : De gjenkjente mønstrene konverteres til tekst, og algoritmer for naturlig språkbehandling (NLP) tolker betydningen.
Brukstilfeller for talegjenkjenning
Stemmegjenkjenningsteknologi har et bredt spekter av applikasjoner på tvers av ulike felt. Her er noen viktige brukstilfeller:
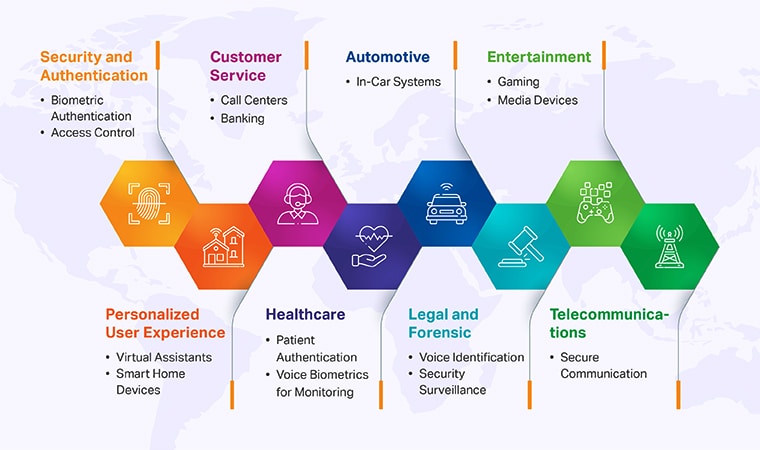
- Sikkerhet og autentisering:
- Biometrisk autentisering: Brukes i smarttelefoner og andre enheter for å låse opp skjermer og bekrefte brukerens identitet.
- Access Control: Sikrer tilgang til bygninger, sikre områder og konfidensiell informasjon ved å gjenkjenne autorisert personell.
- Produkter for stemmegjenkjenningEksempler inkluderer smarthjemenheter og sikkerhetssystemer som bruker stemmegjenkjenning for håndfri kontroll og forbedret sikkerhet.
- Personlig tilpasset brukeropplevelse:
- Virtuelle assistenter: Tilpasser svar og handlinger basert på brukerens stemme, og gir en mer personlig interaksjon.
- Smarte hjem enheterGjenkjenner stemmene til ulike familiemedlemmer for å skreddersy innstillinger og preferanser for hver enkelt person. Hver av disse håndfrie enhetene utløses av et vekkeord – og det krever tilpasning å bygge en nøyaktig, merkespesifikk stemme for produktet ditt. treningsdata for wake word.
- StemmeskrivingBrukes som et produktivitetsverktøy for dataregistrering og automatisering, og forbedrer effektivitet og nøyaktighet i ulike miljøer.
- Kundeservice:
- Ringesentre: Identifiserer kunder med stemmen deres, muliggjør personlig service og reduserer behovet for gjentatt identitetsverifisering.
- Banking: Verifiserer kunder under telefonbanktransaksjoner for sikker og effektiv service.
- Tale-til-tekst-programvareKonverterer talespråk til skriftlig tekst, noe som forbedrer effektivitet, kundeservice og nøyaktighet i kommunikasjon.
- Helsevesen:
- Pasientautentisering: Bekrefter pasientidentitet i telehelsetjenester og elektroniske helsejournaler.
- Stemmebiometri for overvåking: Overvåker pasienter med tilstander som depresjon ved å analysere endringer i stemmemønstre.
- Legens virtuelle assistent: Konverterer legens tale til tekstnotater slik at legen kan se og analysere flere pasienter i løpet av dagen.
- TredjepartsapplikasjonerMedisinske assistenter og helseverktøy integrerer talegjenkjenning for forbedret funksjonalitet.
- Biler:
- Systemer i bilen: Gjenkjenner førerens stemme for å justere preferanser, få tilgang til navigasjon og kontrollere infotainmentsystemer uten manuell inntasting.
- Håndfri opplevelse: Svar på telefonsamtaler, endre sang, svar på meldinger eller få retning uten å måtte forlate rattet; Dette øker ikke bare sikkerheten på veien, men gir også bedre kjøreopplevelse.
- Juridisk og rettsmedisinsk:
- Stemmeidentifikasjon: Brukes i juridiske undersøkelser for å identifisere høyttalere i lydopptak.
- Sikkerhetsovervåking: Forbedrer sikkerhetstiltak ved å identifisere enkeltpersoner gjennom stemme i overvåkingssystemer.
- DomstolrapporteringAvansert talegjenkjenning brukes for nøyaktig juridisk transkripsjon under rettsmøter og avhør, noe som forbedrer effektiviteten og nøyaktigheten i forhold til tradisjonelle rettsrapporteringsmetoder.
- Entertainment:
- Gaming: Tilpasser spillopplevelser ved å gjenkjenne spillernes stemmer.
- Medieenheter: Identifiserer brukere for å tilpasse innholdsanbefalinger og profiler på strømmeenheter.
- Telekommunikasjon:
- Sikker kommunikasjon: Sikrer sikre kommunikasjonskanaler ved å verifisere identiteten til deltakere i konfidensielle samtaler.
- StemmegrensesnittMuliggjør naturlige, samtalebaserte interaksjoner i generativ AI og smarte enheter, noe som gjør brukeropplevelsene mer intuitive.
- Flere enheter og mobile enheterStemmegjenkjenningsteknologi fungerer sømløst på tvers av flere enheter, inkludert mobile enheter og Android-telefoner, og støtter produktivitet og brukeropplevelse på farten.
- Arbeid med gjenkjenningsprogramvareModerne gjenkjenningsprogramvare støtter forskjellige språk, tilbyr flerspråklig støtte og gir kompatibilitet med mobile enheter og ulike plattformer for stemmekontroll.
- Arbeid med programvare for stemmegjenkjenningProgramvare for talegjenkjenning fungerer på tvers av ulike plattformer, støtter flere språk og integreres med tredjepartsapplikasjoner for forbedret funksjonalitet.
- Støtte for forskjellige språkModerne talegjenkjenningssystemer kan veksle mellom forskjellige språk, dialekter og aksenter, noe som gjør dem allsidige for global bruk.
Eksempel på stemmegjenkjenningsteknologi
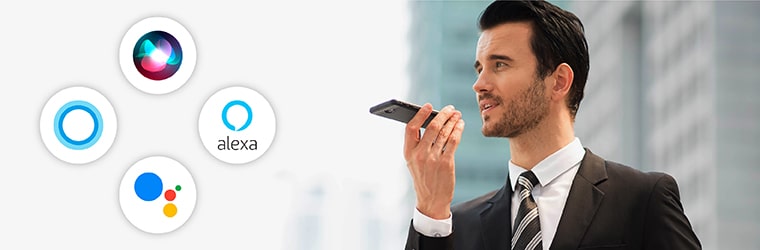
- Apple Siri: Tenk deg å ha en vittig, kunnskapsrik venn i lommen, alltid klar til å hjelpe. Det er Siri for deg. Enten du skynder deg til et møte og trenger å sende en kjapp tekstmelding, eller du er dypt inne i kakedeig og trenger å stille inn en tidtaker, er Siri der, gjenkjenner stemmen din og svarer med et snev av personlighet. Det er som å ha en personlig assistent som kjenner deg så godt at de nesten kan fullføre setningene dine.
- Amazon Alexa: Se for deg å gå inn i hjemmet ditt etter en lang dag og si: "Alexa, jeg er hjemme." Plutselig begynner avslapningsspillelisten din å spille av, lysene dempes til dine foretrukne kveldsinnstilling, og Alexa minner deg om det programmet du har tenkt å se. Det er som hjemmet ditt gir deg en personlig, trøstende klem hver gang du kommer tilbake.
- Google-assistent: Tenk på Google Assistant som din allvitende venn. Enten du lurer på været, trenger å avgjøre en vennlig debatt eller ønsker å kontrollere smarthjemmet ditt, er det der, gjenkjenner stemmen din og skreddersyr svarene for deg. Det er som å ha en supersmart venn som alltid er glad for å hjelpe og aldri blir lei av spørsmålene dine.
- Nuance Dragon NaturallySpeaking: Tenk deg at du kan helle tankene dine på papir så fort du kan si dem. Det er magien med Dragon NaturallySpeaking. For en romanforfatter som lager sin neste bestselger eller en lege som oppdaterer pasientjournaler, er det som å ha en supereffektiv, aldri slitsom transkriberer som forstår hvert ord, aksent og nyanser i stemmen din. Det er ikke bare å skrive – det frigjør tankene dine.
- Microsoft Cortana: Cortana er som å ha en personlig arrangør som alltid er et skritt foran. Se for deg selv en hektisk mandag morgen, og Cortana sier: «Basert på stemmen din høres du litt stresset ut. Skal jeg omplanlegge dine mindre presserende møter til senere denne uken?» Det handler ikke bare om å administrere timeplanen din; det handler om å ha en digital alliert som forstår nyansene i stemmen din og bidrar til å gjøre dagen din jevnere.