Store multimodale modeller (LMM) er en revolusjon innen kunstig intelligens (AI). I motsetning til tradisjonelle AI-modeller som opererer innenfor et enkelt datamiljø som tekst, bilder eller lyd, er LMM-er i stand til å lage og behandle flere modaliteter samtidig.
Derfor genereringen av utganger med kontekstbevisst multimedieinformasjon. Hensikten med denne artikkelen er å avdekke hva LMM-er er, hvordan de blir forskjellige fra LLM-er, og hvor de kan brukes, basert på teknologier som gjør dette mulig.
Store multimodale modeller forklart
LMM-er er AI-systemer som kan behandle og tolke flere typer datamodaliteter. En modalitet er et begrep som brukes for å representere enhver datastruktur som kan legges inn i et system. Kort sagt, tradisjonelle AI-modeller fungerer på bare én modalitet (for eksempel tekstbaserte språkmodeller eller bildegjenkjenningssystemer) om gangen; LMM-er bryter denne barrieren ved å bringe informasjon fra forskjellige kilder inn i et felles rammeverk for analyse.
For eksempel kan LLM-er være et av AI-systemene som kan lese en nyhetsartikkel (tekst), analysere de medfølgende fotografiene (bildene) og korrelere det med relaterte videoklipp for å gi et omfattende sammendrag.
Den kan lese et bilde av en meny på et fremmedspråk, gjøre en tekstoversettelse av den og gi kostholdsanbefalinger avhengig av innholdet. Slik modalitetsintegrasjon åpner en kosmisk dør for LMM-er til å gjøre de tingene som tidligere var vanskelige for unimodale AI-systemer.
Hvordan LMM-er fungerer
Metodene som gjør det mulig for LMM-er å håndtere multimodale data effektivt og optimalt, kan grupperes i arkitekturer og treningsteknikker. Slik fungerer de:
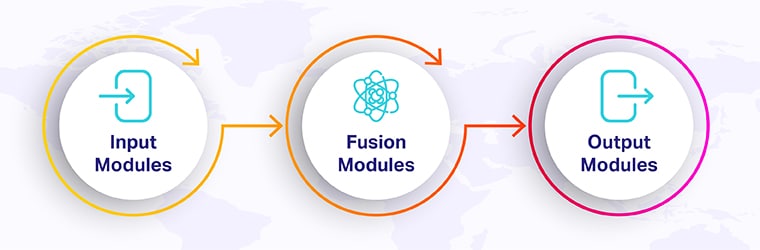
- Inngangsmoduler: Emosjonelle og distinkte nevrale nettverk styrer alle modaliteter. I dette tilfellet vil tekst være en naturlig språkbehandling av en naturlig språkbehandlingsmodell (NLP); et bilde vil være et konvolusjonelt nevralt nettverk (CNN); og lyd vil være en trent RNN eller transformator.
- Fusjonsmoduler: Dette vil ta utgangene fra inngangsmodulene og kombinere dem til en enkelt representasjon.
- Utgangsmoduler: Her gir den sammenslåtte representasjonen plass til å generere et resultat i form av en prediksjon, beslutning eller respons. For eksempel – generering av bildetekster om et bildesvar-spørsmål om en video som oversetter talt til handling.
[Les også: Hva er de beste multimodale AI-applikasjonene og brukstilfellene? ]
LMM-er vs. LLM-er: nøkkelforskjeller
| Trekk | Store språkmodeller (LLMs) | Store multimodale modeller (LMM) |
|---|---|---|
| Datamodalitet | Kun tekst | Tekst, bilder, lyd, video |
| Ekspertiser | Språkforståelse og generering | Cross-modal forståelse og generasjon |
| Applikasjoner | Skrive artikler, oppsummere dokumenter | Bildeteksting, videoanalyse, multimodal spørsmål og svar |
| Treningsdata | Tekstkorpus | Tekst + bilder + lyd + video |
| Eksempler | GPT-4 (bare tekstmodus) | GPT-4 Vision, Google Gemini |
Applikasjoner for store multimodale modeller
Siden LMM-ene kan beregne flere typer data samtidig, er graden av deres applikasjoner og spredning svært høye i forskjellige sektorer.
Hvordan kan Shaip hjelpe?
Der det er stort potensial, finnes det også utfordringer med integrasjon, skalering, beregningskostnader og intermodal konsistens, noe som kan sette begrensninger på fullstendig adopsjon av disse modellene. Det er her Shaip kommer inn i bildet. Våre multimodale AI-datatjenester leverer varierte og godt kommenterte datasett av høy kvalitet på tvers av tekst, bilde, lyd og video – alt i henhold til strenge samsvarsretningslinjer.
Med våre tilpassede datatjenester og merknadstjenester sikrer Shaip at LMM-er opprinnelig ble trent på gyldige og merkbart operasjonelle datasett, og gjør dermed bedrifter i stand til å takle de omfattende potensialene til multimodal AI mens de samtidig presterer effektivt og skalerbart.