Hva er multimodal datamerking? Komplett guide 2025
Den raske utviklingen av AI-modeller som OpenAIs GPT-4o og Googles Gemini har revolusjonert hvordan vi tenker på kunstig intelligens. Disse sofistikerte systemene behandler ikke bare tekst – de integrerer sømløst bilder, lyd, video og sensordata for å skape mer intelligente og kontekstuelle responser. I kjernen av denne revolusjonen ligger en kritisk prosess: multimodal datamerking.
Men hva er egentlig multimodal datamerking, og hvorfor har det blitt grunnleggende for moderne AI-utvikling? Denne omfattende guiden utforsker alt du trenger å vite om denne viktige teknikken som former fremtiden for kunstig intelligens.
Forståelse av multimodal datamerking
Multimodal datamerking er prosessen med å annotere og kategorisere flere typer data samtidig for å trene AI-modeller som kan behandle og forstå ulike dataformater. I motsetning til tradisjonelle merkingsmetoder som fokuserer på én enkelt datatype, skaper multimodal merking forbindelser og relasjoner mellom ulike modaliteter – tekst, bilder, lyd, video og sensordata – slik at AI-systemer kan utvikle en mer omfattende forståelse av komplekse scenarier i den virkelige verden.
Tenk på det som å lære en AI å forstå verden slik mennesker gjør. Når vi ser på en film, ser vi ikke bare bilder eller hører lyder isolert – vi behandler visuelle signaler, dialog, musikk og kontekst samtidig. Multimodal datamerking gjør det mulig for AI-systemer å utvikle lignende funksjoner.
De fem kjernedatamodalitetene
For å virkelig forstå multimodal datamerking, er det viktig å forstå de ulike typene datamodaliteter som er involvert:
Bildedata
Visuell informasjon i form av fotografier, medisinske skanninger, skisser eller tekniske tegninger. For eksempel inkluderer medisinske bildedatasett røntgenbilder, CT-skanninger og MR-bilder som krever presis annotering for AI-drevne diagnostiske systemer.
Tekstdata
Naturlig språkinnhold fra dokumenter, rapporter, innlegg på sosiale medier eller transkripsjoner. Dette inkluderer alt fra kliniske notater til kundeanmeldelser.
Videodata
Bevegelige bilder kombinert med lyd, skaper tidsmessige forhold mellom visuell og auditiv informasjon. Videoannotering er spesielt viktig for applikasjoner som autonom kjøring og sikkerhetssystemer.
Lyddata
Lydopptak, inkludert tale, musikk, miljølyder eller medisinsk lyd som hjerteslag. Innsamling av taledata på tvers av flere språk og dialekter er avgjørende for å bygge robuste AI-konversasjonssystemer.
Sensordata
Informasjon fra IoT-enheter, GPS-systemer, akselerometre eller medisinsk overvåkingsutstyr. Denne datatypen blir stadig viktigere for helsevesenets AI og smartbyapplikasjoner.
Hvorfor multimodal datamerking er viktig
Betydningen av multimodal datamerking går langt utover de tekniske kravene. I følge nyere bransjeforskning viser modeller trent på korrekt merkede multimodale data opptil 40 % bedre ytelse i virkelige applikasjoner sammenlignet med modeller med én modalitet. Denne forbedringen oversettes direkte til mer nøyaktige medisinske diagnoser, tryggere autonome kjøretøy og mer naturlige interaksjoner mellom menneske og kunstig intelligens.
Tenk deg et pasientdiagnosesystem: en unimodal modell som kun analyserer tekstregistreringer, kan gå glipp av kritiske visuelle indikatorer fra røntgenbilder eller subtile lydsignaler fra hjerteundersøkelser. Ved å innlemme multimodale treningsdata kan AI-systemer syntetisere informasjon fra pasientjournaler, medisinsk avbildning, lydopptak fra stetoskoper og sensordata fra bærbare enheter – og dermed skape en omfattende helsevurdering som speiler hvordan menneskelige leger evaluerer pasienter.
Utviklingen fra manuell til automatisert multimodal datamerking har forvandlet AI-utviklingslandskapet. Mens tidlige annoteringsarbeid utelukkende var avhengig av menneskelige merkingere som jobbet med grunnleggende verktøy, utnytter dagens plattformer maskinlæring for å akselerere og forbedre merkingsprosessen.
Ledende annoteringsplattformer
Moderne annoteringsplattformer tilbyr enhetlige miljøer for håndtering av ulike datatyper. Disse verktøyene støtter:
Integrerte arbeidsflyter for tekst-, bilde-, lyd- og videoannotering
Kvalitetskontrollmekanismer for å sikre nøyaktighet i merkingen
Funksjoner for samarbeid for distribuerte team
API-integrasjoner med eksisterende ML-pipelines
Shaips dataannoteringstjenester eksemplifiserer denne utviklingen, og tilbyr tilpassbare arbeidsflyter som tilpasser seg spesifikke prosjektkrav, samtidig som de opprettholder strenge kvalitetsstandarder gjennom valideringsprosesser på flere nivåer.
Automatisering og AI-assistert merking
Integreringen av AI i selve merkeprosessen har skapt en kraftig tilbakemeldingssløyfe. Forhåndstrente modeller foreslår innledende etiketter, som menneskelige eksperter deretter verifiserer og forbedrer. Denne halvautomatiske tilnærmingen reduserer merketiden med opptil 70 %, samtidig som den opprettholder nøyaktigheten som er avgjørende for å trene robuste multimodale modeller.
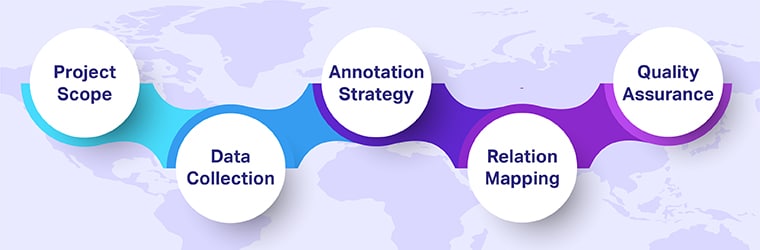
Den multimodale datamerkingsprosessen
Vellykket merking av multimodale data krever en systematisk tilnærming som adresserer de unike utfordringene til hver datatype, samtidig som den opprettholder konsistens på tvers av modaler.
Trinn 1: Definisjon av prosjektomfang
Begynn med å tydelig identifisere hvilke modaliteter AI-modellen din trenger og hvordan de vil samhandle. Definer suksessmålinger og etabler kvalitetsstandarder for hver datatype.
Trinn 2: Datainnsamling og forberedelse
Samle inn ulike datasett som representerer alle nødvendige modaliteter. Sørg for tidsmessig justering av synkroniserte data (som video med lyd) og oppretthold konsistent formatering på tvers av kilder.
Trinn 3: Utvikling av annoteringsstrategi
Lag detaljerte retningslinjer for hver modalitet:
Bilder: Avgrensningsbokser, segmenteringsmasker, annoteringer av viktige punkter
Den kritiske differensieringen innen multimodal merking er å etablere forbindelser mellom modaliteter. Dette kan innebære å koble tekstbeskrivelser til bestemte bildeområder eller synkronisere lydtranskripter med tidsstempler for videoer.
Trinn 5: Kvalitetssikring og validering
Implementer flerlags gjennomgangsprosesser der ulike annotatorer verifiserer hverandres arbeid. Bruk målinger for avtaler mellom annotatorer for å sikre konsistens på tvers av datasettet.
Virkelige applikasjoner som transformerer bransjer
Autonom kjøretøyutvikling
Selvkjørende biler representerer kanskje den mest komplekse multimodale utfordringen. Disse systemene må behandle samtidig:
Visuelle data fra flere kameraer
LIDAR punktskyer for 3D-kartlegging
Radar signaler for objektdeteksjon
GPS koordinater for navigasjon
lyd sensorer for deteksjon av utrykningskjøretøy
Nøyaktig multimodal merking av disse dataene gjør det mulig for kjøretøy å ta beslutninger på et splittsekund i komplekse trafikkscenarioer, noe som potensielt redder tusenvis av liv årlig.
Helsevesenets AI-revolusjon
Helsevesenets AI-løsninger i økende grad stoler på multimodale data for å forbedre pasientutfall. En omfattende diagnostisk AI kan analysere:
Elektroniske helsejournaler (tekst)
Medisinsk avbildning (visuell)
Legediktatnotater (lyd)
Vitale tegn fra overvåkingsenheter (sensordata)
Denne helhetlige tilnærmingen muliggjør tidligere sykdomsdeteksjon og mer personlige behandlingsplaner.
Neste generasjons virtuelle assistenter
Moderne samtalebasert AI går utover enkle tekstsvar. Multimodale virtuelle assistenter kan:
Forstå talte spørsmål med visuell kontekst
Generer svar ved å kombinere tekst, bilder og tale
Tolk brukerens følelser gjennom stemmeleie og ansiktsuttrykk
Gi kontekstuelt relevante visuelle hjelpemidler under forklaringer
Overvinne utfordringer med multimodal merking
Kompleksitet datasynkronisering
Det er fortsatt en betydelig utfordring å samkjøre data fra ulike kilder som opererer med ulike oppløsninger og tidsskalaer. Løsningene inkluderer:
Implementering av robuste tidsstempelprotokoller
Bruk av spesialisert synkroniseringsprogramvare
Opprette enhetlige dataformater for sømløs integrasjon
Bekymringer om skalerbarhet
Den store mengden multimodale data kan overvelde tradisjonelle annoteringsarbeidsflyter. Organisasjoner håndterer dette gjennom:
Skybaserte annoteringsplattformer
Distribuerte merketeam
Automatisert forhåndsmerking med menneskelig verifisering
Opprettholde konsistens i annoteringer
Å sikre konsistent merking på tvers av modaliteter krever:
Etter hvert som AI-modeller blir stadig mer sofistikerte, vil multimodal datamerking fortsette å utvikle seg. Fremvoksende trender inkluderer:
Zero-shot læring reduserer merkekravene
Selvstyrte tilnærminger utnytte umerkede multimodale data
Federert merking bevare personvernet samtidig som modeller forbedres
Sanntidskommentar for strømming av multimodale data
Konklusjon
Multimodal datamerking står i forkant av AI-utviklingen, og muliggjør systemer som forstår og samhandler med verden på stadig mer menneskelignende måter. Etter hvert som modeller fortsetter å vokse i kompleksitet og kapasitet, vil kvaliteten og sofistikasjonen til multimodal datamerking i stor grad avgjøre deres effektivitet i den virkelige verden.
Organisasjoner som ønsker å utvikle banebrytende AI-løsninger, må investere i robuste multimodale datamerkingsstrategier, og utnytte både avanserte verktøy og menneskelig ekspertise for å lage de høykvalitets opplæringsdataene som morgendagens AI-systemer krever. Kontakt oss i dag.
Hvor lang tid tar det vanligvis å merke multimodal data?
Tidslinjen varierer betydelig basert på datavolum og kompleksitet. Et mellomstort prosjekt med 100,000 4 multimodale datapunkter krever vanligvis 8–XNUMX uker med et profesjonelt annoteringsteam.
Hva er forskjellen mellom multimodal og unimodal merking?
Unimodal merking fokuserer på én datatype (bare tekst eller bare bilder), mens multimodal merking annoteres på flere datatyper og, viktigst av alt, forholdet mellom dem.
Kan små team effektivt utføre multimodal datamerking?
Ja, med de riktige verktøyene og arbeidsflytene. Skybaserte plattformer gjør det mulig for små team å administrere store multimodale prosjekter ved å utnytte automatisering og distribuerte arbeidsflyter.
Hvordan sikrer du kvalitet i multimodal datamerking?
Kvalitetssikring innebærer flerlags gjennomgangsprosesser, målinger av avtaler mellom annotatorer, automatiserte valideringskontroller og kontinuerlig opplæring og tilbakemeldinger for annotatorer.
Hvilke bransjer drar mest nytte av multimodal datamerking?
Helsevesen, bilindustri, detaljhandel, sikkerhet og underholdningsbransjen ser størst avkastning fra multimodale AI-systemer som er trent på riktig merkede data.
Likte du denne artikkelen? Følg Shaip på LinkedIn for flere oppdateringer.
Inneholder informasjon relatert til brukerens markedsføringskampanjer. Disse deles med Google AdWords/Google Ads når Google Ads- og Google Analytics-kontoene er koblet sammen.
90 dager
__utma
ID brukt til å identifisere brukere og økter
2 år etter siste aktivitet
__utmt
Brukes til å overvåke antall Google Analytics-serverforespørsler
10 minutter
__utmb
Brukes til å skille mellom nye økter og besøk. Denne informasjonskapselen settes når GA.js javascript-biblioteket lastes inn og det ikke finnes noen eksisterende __utmb-informasjonskapsel. Informasjonskapselen oppdateres hver gang data sendes til Google Analytics-serveren.
30 minutter etter siste aktivitet
__utmc
Brukes kun med gamle Urchin-versjoner av Google Analytics og ikke med GA.js. Ble brukt til å skille mellom nye økter og besøk på slutten av en økt.
Slutt på økten (nettleser)
__utmz
Inneholder informasjon om trafikkilden eller kampanjen som ledet brukeren til nettstedet. Informasjonskapselen settes når GA.js-javascriptet lastes inn og oppdateres når data sendes til Google Analytics-serveren.
6 måneder etter siste aktivitet
__utmv
Inneholder tilpasset informasjon angitt av nettutvikleren via _setCustomVar-metoden i Google Analytics. Denne informasjonskapselen oppdateres hver gang nye data sendes til Google Analytics-serveren.
2 år etter siste aktivitet
__utmx
Brukes til å avgjøre om en bruker er inkludert i en A/B- eller multivariattest.
18 måneder
_ga
ID som brukes til å identifisere brukere
2 år
_gali
Brukes av Google Analytics for å bestemme hvilke lenker på en side som blir klikket på
30 sekunder
_ga_
ID som brukes til å identifisere brukere
2 år
_gid
ID brukt til å identifisere brukere i 24 timer etter siste aktivitet
24 timer
_gat
Brukes til å overvåke antall Google Analytics-serverforespørsler når du bruker Google Tag Manager
1 minutt
Markedsføringsinformasjonskapsler brukes til å følge besøkende til nettsider. Hensikten er å vise annonser som er relevante og engasjerende for den enkelte bruker.
Google Ads er en nettbasert annonseringsplattform som lar bedrifter lage målrettede annonser som vises i Googles søkeresultater og partnersider.
Målrettingsinformasjonskapsel. Brukes til å opprette en brukerprofil og vise relevante og personlige Google-annonser til brukeren.
2 år
__Secure-1PSID
Målrettingsinformasjonskapsel. Brukes til å opprette en brukerprofil og vise relevante og personlige Google-annonser til brukeren.
2 år
__Secure-3PAPISID
Profilerer interessene til nettstedsbesøkende for å vise relevante og personlige annonser gjennom retargeting.
2 år
AEC
AEC-informasjonskapsler sikrer at forespørsler i en nettleserøkt gjøres av brukeren, og ikke av andre nettsteder. Disse informasjonskapslene forhindrer at ondsinnede nettsteder handler på vegne av en bruker uten at brukeren er klar over det.
6 måneder
ADS_VISITOR_ID
Informasjonskapsel kreves for å bruke alternativene og nettjenestene på nettstedet
2 måneder
__Secure-3PSIDCC
Målrettingsinformasjonskapsel. Brukes til å opprette en brukerprofil og vise relevante og personlige Google-annonser til brukeren.
2 år
__Secure-3PSIDTS
Målrettingsinformasjonskapsel. Brukes til å opprette en brukerprofil og vise relevante og personlige Google-annonser til brukeren.
2 år
__Secure-1PSIDTS
Målrettingsinformasjonskapsel. Brukes til å opprette en brukerprofil og vise relevante og personlige Google-annonser til brukeren.
2 år
__Secure-1PAPISID
Målrettingsinformasjonskapsel. Brukes til å opprette en brukerprofil og vise relevante og personlige Google-annonser til brukeren.
2 år
__Secure-3PSID
Målrettingsinformasjonskapsel. Brukes til å profilere interessene til besøkende på nettstedet og vise relevante og personlige Google-annonser.
2 år
Konvertering
Google bruker informasjonskapsler til annonsering, inkludert visning og gjengivelse av annonser, personlig tilpasning av annonser (avhengig av annonseinnstillingene dine på g.co/adsettings), begrensning av antall ganger en annonse vises til en bruker, deaktivering av annonser du har valgt å slutte å se og måling av effektiviteten til annonser.
90 dager
_gcl_aw
Google bruker informasjonskapsler til annonsering, inkludert visning og gjengivelse av annonser, personlig tilpasning av annonser (avhengig av annonseinnstillingene dine på g.co/adsettings), begrensning av antall ganger en annonse vises til en bruker, deaktivering av annonser du har valgt å slutte å se og måling av effektiviteten til annonser.
90 dager
_gcl_gs
Google bruker informasjonskapsler til annonsering, inkludert visning og gjengivelse av annonser, personlig tilpasning av annonser (avhengig av annonseinnstillingene dine på g.co/adsettings), begrensning av antall ganger en annonse vises til en bruker, deaktivering av annonser du har valgt å slutte å se og måling av effektiviteten til annonser.
90 dager
_gcl_gb
Google bruker informasjonskapsler til annonsering, inkludert visning og gjengivelse av annonser, personlig tilpasning av annonser (avhengig av annonseinnstillingene dine på g.co/adsettings), begrensning av antall ganger en annonse vises til en bruker, deaktivering av annonser du har valgt å slutte å se og måling av effektiviteten til annonser.
90 dager
_gac_gb_
Google bruker informasjonskapsler til annonsering, inkludert visning og gjengivelse av annonser, personlig tilpasning av annonser (avhengig av annonseinnstillingene dine på g.co/adsettings), begrensning av antall ganger en annonse vises til en bruker, deaktivering av annonser du har valgt å slutte å se og måling av effektiviteten til annonser.
90 dager
FPGCLGB
Google bruker informasjonskapsler til annonsering, inkludert visning og gjengivelse av annonser, personlig tilpasning av annonser (avhengig av annonseinnstillingene dine på g.co/adsettings), begrensning av antall ganger en annonse vises til en bruker, deaktivering av annonser du har valgt å slutte å se og måling av effektiviteten til annonser.
90 dager
FPGCLAW
Google bruker informasjonskapsler til annonsering, inkludert visning og gjengivelse av annonser, personlig tilpasning av annonser (avhengig av annonseinnstillingene dine på g.co/adsettings), begrensning av antall ganger en annonse vises til en bruker, deaktivering av annonser du har valgt å slutte å se og måling av effektiviteten til annonser.
90 dager
HubSpot er en alt-i-ett-plattform for markedsføring, salg og kundeservice som effektiviserer forretningsvekst.
Denne informasjonskapselen brukes til å gjenkjenne besøkende som chatter med deg via chatflows-verktøyet. Hvis den besøkende forlater nettstedet ditt før de er lagt til som en kontakt, vil denne informasjonskapselen være knyttet til nettleseren sin.
13 måneder
__hs_do_not_track
Denne informasjonskapselen kan settes for å forhindre at sporingskoden sender informasjon til HubSpot.
13 måneder
__hs_cookie_cat_pref
Denne informasjonskapselen brukes til å registrere kategoriene en besøkende har samtykket til.
6 måneder
__hs_initial_opt_in
Denne informasjonskapselen brukes til å forhindre at banneret alltid vises når besøkende surfer i streng modus.
7 dager
__hs_gpc_banner_dismiss
Denne informasjonskapselen brukes når banneret for global personvernkontroll lukkes.
180 dager
hs_ab_test
Denne informasjonskapselen brukes til konsekvent å betjene besøkende den samme versjonen av en A/B-testside som de har sett før.
Session
__hs_notify_banner_dismiss
Denne informasjonskapselen brukes når nettstedet bruker en bannertype for samtykkevarsling.
180 dager
HS-meldinger-er-åpen
Denne informasjonskapselen brukes til å bestemme og lagre om chat-widgeten er åpen for fremtidige besøk.
30 minutter
hs-meldinger-skjul-velkomstmelding
Denne informasjonskapselen brukes til å forhindre at velkomstmeldingen for chat-widgeten vises igjen i én dag etter at den er avvist.
1 dag
__hsmem
Denne informasjonskapselen settes når besøkende logger seg på et nettsted som er hostet av HubSpot.
1 år
hs-medlemskap-csrf
Denne informasjonskapselen brukes for å sikre at innlogginger for innholdsmedlemskap ikke kan forfalskes.
Session
hs_langswitcher_choice
Denne informasjonskapselen brukes til å lagre den besøkendes valgte språkvalg når sider vises på flere språk.
2 år
__hstc
Den viktigste informasjonskapselen for sporing av besøkende.
13 måneder
hubspotutk
Denne informasjonskapselen sporer en besøkendes identitet. Den sendes til HubSpot når skjemaet sendes inn og brukes til å deduplisere kontakter.
13 måneder
__hssc
Denne informasjonskapselen holder oversikt over økter.
30 minutter
__hssrc
Når HubSpot endrer øktinformasjonskapselen, settes denne informasjonskapselen også til å avgjøre om den besøkende har startet nettleseren sin på nytt.
Session
hubspotapi-preferanser
Dette brukes sammen med hubspotapi-informasjonskapselen for å huske om brukeren har merket av i boksen «husk meg» (kontrollerer utløpet av hovedinformasjonskapselens autentisering).
1 År
hubspotapi-csrf
Dette brukes til CSRF-forebygging – å forhindre at tredjepartsnettsteder får tilgang til dataene dine. Utløper etter et år.
1 år
__hs_opt_out
Denne informasjonskapselen brukes av personvernerklæringen for påmelding for å huske at den besøkende ikke blir bedt om å godta informasjonskapsler igjen.
13 måneder
hubspotapi
Denne informasjonskapselen lar brukeren få tilgang til appen med de riktige tillatelsene.