Tenk deg å snakke med smarttelefonen din, lytte til favorittartiklene dine lest høyt mens du kjører, eller lære et nytt språk med perfekt uttale – alt uten menneskelig innblanding. Dette er magien med tekst-til-tale-teknologi (TTS).
Bedrifter investerer også tungt i TTS, spesielt etter AI-boomen. TTS-markedet ble verdsatt til 3.2 milliarder dollar i 2023 og forventes å nå 7 milliarder dollar innen 2030, med en årlig vekstrate (CAGR) på 12 %.
Det som startet som en enkel funksjon har nå utviklet seg til noe helt annet – Conversational AI. Tekst-til-tale er den samme teknologien som nå driver virtuelle assistenter, kundeserviceroboter osv. Så i denne guiden vil vi lede deg gjennom alt du trenger å vite om tekst-til-tale.
Men hva er tekst-til-tale og hvordan fungerer det?
I kjernen handler Text-to-Speech (TTS)-teknologi om å gi en stemme til teksten. Enkelt sagt vil den ta teksten som et input som kan være i hvilken som helst form, inkludert en setning, et avsnitt eller et helt dokument – og transformere den til talespråk. For det meste er den genererte stemmen nær menneskelig stemme, men den kan variere fra produkt til produkt.
Et godt eksempel er Google Assistants stemme høres robotisk ut, men på den annen side er moderne AI-verktøy som hume.ai veldig nær menneskelig stemme.
Som all annen teknologi, ble også TTS-teknologi kompleks med tiden ettersom flere AI- og ML-algoritmer ble lagt til for å forbedre dens kapasitet. Men for enkelhets skyld har vi delt tekst-til-tale i tre deler.
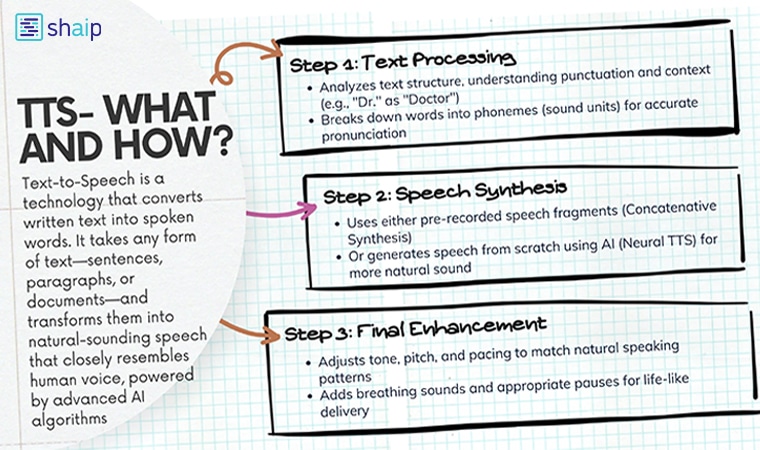
Trinn 1: Tekstbehandling
Dette er det første trinnet, hvor TTS-systemet forbereder teksten for tale. Her er hva som skjer:
- Analyse av teksten: Systemet vil først skanne teksten for å forstå strukturen som inkluderer alt fra tegnsetting, forkortelser og partall. Ved å gjøre det kan systemet få en bedre forståelse av konteksten. Et godt eksempel er at "Dr." gjenkjennes som «Doctor», ikke «Drive».
- Å bryte ned ord: Senere blir ord delt opp i sine fonetiske komponenter, kjent som fonemer. Dette er et av de avgjørende trinnene for å sikre korrekt uttale. Dette er de minste lydenhetene i tale. Et godt eksempel på å bryte ned ord i fonemer er ordet "katt" som har tre fonemer: /k/, /æ/ og /t/.
- Håndteringskontekst: I dette trinnet vil systemet lære konteksten til teksten for å bestemme hvordan ord skal uttales. For eksempel kan ordet "lead" uttales annerledes i "lead a team" versus "lead pipe."
Trinn 2: Talesyntese
Når teksten er behandlet, er neste trinn å konvertere den til faktisk tale. Dette gjøres ved å bruke en av to hovedmetoder:
- Konkatenativ syntese: Dette er en tradisjonell metode som har vært brukt veldig lenge. Prosessen er ganske enkel der du bruker forhåndsinnspilte fragmenter av menneskelig tale og sy dem sammen for å danne setningen.
For for eksempel å si «Hallo, verden», kan systemet trekke den forhåndsinnspilte lyden for «Hallo» og «verden» og deretter sy dem til en setning. Selv om det er effektivt, er den store ulempen at den genererte lyden kan høres hakkete eller robotaktig ut, spesielt med komplekse setninger. - Nevral TTS (moderne tilnærming): I motsetning til den forrige metoden hvor systemet ville sy forhåndsinnspilte klipp, er Neural TTS en moderne metode og bruker kunstig intelligens og dyp læring for å generere tale fra bunnen av.
For eksempel, for å si "Hei, verden," vil nevrale nettverksteknikken generere hele setningen i en nær naturlig tone som også vil være emosjonell og bøyelig. Dette er grunnen til at du vil finne natt- og dagforskjeller mellom gammel og ny TTS-programvare når det gjelder talekvalitet.
Denne tilnærmingen skaper svært realistisk, uttrykksfull og menneskelignende tale, noe som gjør den til det foretrukne valget for mange avanserte TTS-systemer i dag.
Trinn 3: Legge til siste finpuss
I det siste trinnet legger TTS-systemet til den siste detaljen for å forbedre utgangen:
- Tone og tonehøyde: Det er gjort for å hjelpe til med å uttrykke følelser eller vekt. For eksempel uttrykkes begeistring med en høyere tonehøyde, mens alvoret gjenspeiles i en lavere tone.
- pacing: Den vil justere hastigheten på talen for å matche det naturlige talemønsteret basert på konteksten til teksten.
- Pust og pauser: Dette er det viktigste etter min mening der disse avanserte systemene simulerer naturlige pustelyder og pauser ved hjelp av AI og ML, noe som gjør utgangen mer naturtro. Det beste eksemplet er hvordan NotebookLM genererer lyd fra tekst i samtaleform med pust og pauser som etterligner nøyaktig hvordan mennesket snakker.
Hva er rollen til AI i TTS
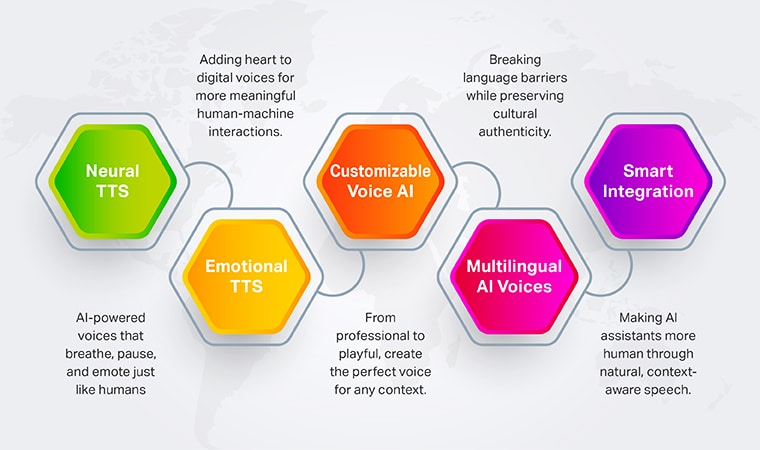
Vi tror at AI har revolusjonert TTS-teknologien og har gjort det mulig for oss viktige funksjoner som vi bruker daglig som evnen til å produsere realistisk og naturlig klingende tale. Sammen med disse funksjonene har nøyaktigheten også forbedret seg i stor grad.
Her er de viktigste bidragene fra AI til TTS-teknologien:
- Nevral TTS for menneskelignende stemmer: Dette er desidert det viktigste bidraget til AI til TTS. Med AI er vi nå vitne til Neural TTS som ikke bare etterligner menneskelignende tale, men også har følelser, pauser og dybde som ikke er mulig uten AI. I motsetning til tradisjonelle metoder, skaper den flytende, naturtro stemmer uten å stole på forhåndsinnspilte segmenter.
- Følelsesmessig berøring: Med AI kan tekst-til-tale-systemer generere lyd som har følelser. Dette er spesielt nyttig når du snakker med en chatbot og den har en ettertrykkelig stemme som er gunstig for både bedrifter og brukere. Dette er grunnen til at flere og flere TTS-systemer nå blir brukt i historiefortelling, terapi og virtuelle assistenter.
- Tilpassbare AI-stemmer: Siden integreringen av AI med TTS, kan du lage personlige stemmer for personlig og profesjonell bruk, da tonen enkelt kan endres etter behov. For eksempel kan bedrifter bygge empatiske modeller med toner som matcher denne brukssaken, men på den annen side, hvis en person ønsker å bygge noe for moro skyld, kan de bygge en modell som høres ut som JARVIS, et filminspirert verktøy.
- Flerspråklig og aksentstøtte: Med AI kan TTS-systemer enkelt forstå og svare på flere språk. På denne måten kan bedrifter sikre inkludering og tilgjengelighet for globale publikum. Men det beste er at det også tilpasser seg regionale nyanser som til slutt forbedrer relatabiliteten.
- Integrasjon med Conversational AI: TTS når integrert med AI har blitt en integrert del av moderne AI-assistenter som Alexa og Siri. Det sikrer at disse assistentene leverer svar som er samtalemessige, engasjerende og kontekstuelt passende.
Utfordringer som selskaper møter for å utvikle TTS
Til tross for moderne teknologi, er det flere utfordringer som selskaper står overfor for å utvikle og utnytte det sanne potensialet til TTS. Her er noen av hovedproblemene:
- Datatilgjengelighet og kvalitet: Resultatet av TTS-systemet er sterkt avhengig av kvaliteten på datasettene og bedrifter trenger store mengder kvalitetsdata som er vanskelige å finne og kostbare å kjøpe.
- Oppnå naturlighet og uttrykksevne: Dette er et av de mest avgjørende problemene som bedrifter står overfor, og det er å oppnå naturlighet og uttrykksfullhet. Mens moderne AI- og ML-algoritmer har løst dette problemet i stor grad, kommer disse systemene ofte til kort i å replikere kontekstsensitive uttrykk som sarkasme eller spenning.
- Høye beregningskostnader: Hvis du ønsker å utvikle avanserte TTS-modeller som er drevet av AI, tilsvarende Tacotron or WaveNet, gjør deg klar til å bruke en uhyggelig sum penger på beregningskraft. Disse avanserte TTS-systemene krever moderne GPU-er for inferencing og opplæring, noe som kan vise seg å være et stort problem for små organisasjoner.
- Flerspråklig og regional tilpasning: Å bygge et TTS-system som alene forstår flere språk og aksenter er et stort problem. Dette er grunnen til at selskaper ofte utvikler flere TTS for flere språk og slår dem sammen for å løse dette problemet. Selv en slik løsning kan kanskje ikke løse dette problemet 100%.
Hvordan kan Shaip omdefinere tekst-til-tale for deg?
Enten du utvikler virtuelle assistenter, interaktive stemmeresponssystemer eller andre AI-drevne stemmeapplikasjoner, er Shaip her for å holde hånden din. Vi har ekspertise innen innsamling og behandling av taledata slik at dine TTS-systemer ikke bare kan gjøres nøyaktige, men også høres naturlig og relevant ut.
Slik kan Shaip heve TTS-prosjektene dine:
- Tilpassede TTS-dataløsninger: Shaip kan gi deg skreddersydde TTS-datasett som oppfyller de spesifikke behovene til prosjektet ditt. Fra opptak av studiokvalitet til scenarier i den virkelige verden, er dataene omhyggelig kurert for å forbedre klarheten og flyten til den genererte talen.
- Taledatakatalog av høy kvalitet: Hos Shaip kan du få tilgang til en veldig stor taledatakatalog og få forhåndsmerket stemmedatasett fra det enorme depotet. Etisk hentede datasett med metadata sikrer at du får den beste kvaliteten på treningsdataene for AI-modellene dine.
- Ekspertvurdering og støtte: Vi går ett skritt utover å levere data. Vi tilbyr også evalueringstjenester som sikrer at TTS oppfyller de høye standardene for naturlig tale og nøyaktighet.
Ved å samarbeide med Shaip får du tilgang til taledataløsninger i verdensklasse som vil forbedre resultatet av ditt neste TTS-system betydelig. Enten du leter etter tilpassede datasett eller ferdige løsninger, spør du og vi får det til å fungere for deg.