
Datasett for maskinlæring
Kjøp og lisensier premium AI-opplæringsdatasett | AI-datakatalog og lisensieringsmarkedsplass
Shaips markedsplass for AI-datakatalog og -lisensiering gir AI-team én enkelt kilde for kjøp og lisensiering av forhåndsmerkede, kommersielt godkjente opplæringsdatasett på tvers av tekst-, tale-, bilde-, video- og multimodale formater. Hvert datasett er menneskemerket, etisk innhentet og leveres klart til opplæring – med fullstendig samsvarsdokumentasjon for GDPR, HIPAA og krav til bedriftsdatastyring.
Enten du finjusterer en stor språkmodell, trener et diagnostisk system for helsevesenet eller akselererer en datasynsprosess, dekker Shaips katalog over 10+ bransjevertikaler med fleksible lisensalternativer: engangskjøp, abonnementstilgang eller tilpassede bedriftsavtaler. Be om et gratis prøvedatasett for å validere kvaliteten før du forplikter deg.
Vi prioriterer etisk datainnhenting gjennom hele vår virksomhet, og sikrer ansvarlig og rettferdig AI-utvikling. Vår strenge og transparente praksis innen datainnsamling, validering og håndtering ivaretar personvernet og opprettholder tilliten til både våre kunder og databidragsytere.
Katalog over fysiske AI-data
Robotlæringsprogrammer lever eller dør på kvaliteten og konsistensen av demonstrasjonsdataene sine. Vår fysiske AI-katalog leverer menneskelige demonstrasjoner, multimodale persepsjonsdata og robottilstands-handlingsepisoder samlet mot et standardisert oppgavebibliotek – og gir VLA-, humanoid-, manipulasjons- og Real2Sim-pipelinene dine de rene, sammenlignbare episodene de trenger for å trene og evaluere pålitelig.
Katalog og lisensiering av fysiske AI-data fra hyllevare:
- Over 1,400 dokumenterte oppgavescenarier på tvers av 9 virkelige miljøer (husholdning, industri, detaljhandel, hotell- og restaurantbransjen med mer)
- Menneskelig demonstrasjon og VLA-treningsepisoder med konsistente starttilstander og suksesskriterier
- Egosentrisk og flervisningsvideo med bevegelses-, positur- og fingerferdighetsopptak
- Episodevarighet fra 0.5–10 minutter på tvers av 4 vanskelighetsnivåer, inkludert verktøybruk

Taledatakatalog
Det finnes en lang rekke vanlige applikasjoner for taledata i AI-prosjekter. Vi tilbyr deg enorme mengder høykvalitetsdata klar for stemmegjenkjenningsproduktene dine som passer budsjettet ditt og kan skaleres etter hvert som du vokser for å trene AI/ML-modellene dine.
Hyllevarekatalog for taledata og lisensiering:
- 55 50 timer med taledata (100+ språk/XNUMX+ dialekter)
- 70+ emner dekket
- Samplingshastighet – 8/16/44/48 kHz
- Lydtype -Spontane, skriptede, monolog, våkne ord
- Fullt transkriberte lyddatasett på flere språk for menneske-menneske-samtale, menneske-bot, menneske-agent call center-samtale, monologer, taler, podcast, etc.
- Uttaleleksikon, både generelle og domenespesifikke (f.eks. navn, steder, naturlige tall)

Medisinsk datakatalog
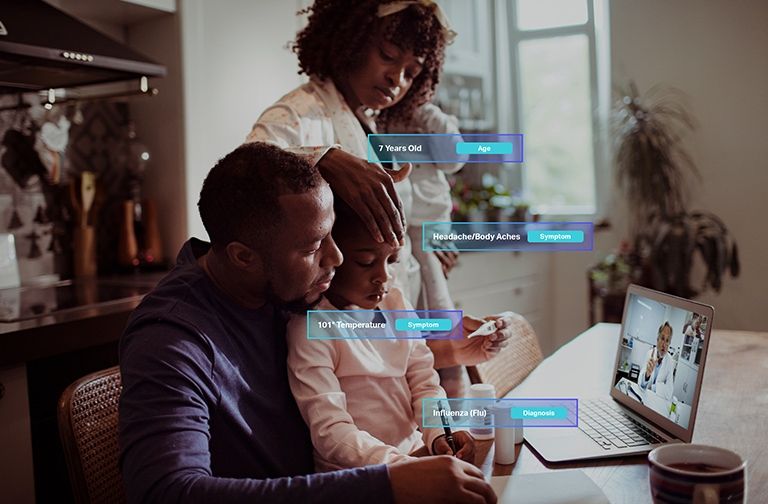
Våre medisinske datakatalogdatasett er ikke bare massive, men har gullstandard kvalitetsdata. Vær trygg på at dataene du bruker er sikre, avidentifiserte og kan stole på for å oppnå de høyeste og mest nøyaktige resultatene for AI-initiativet ditt, maskinlæringsmodeller, naturlig språkbehandling og andre utviklingsprosjekter.
Hyllevarekatalog for medisinske data og lisensiering:
- 5M+ elektroniske helsejournaler og legelydfiler i 31 spesialiteter
- 2M+ medisinske bilder innen radiologi og andre spesialiteter (MR, CT, USG, XR)
- 30 XNUMX kliniske tekstdokumenter med verdiøkende enheter og relasjonskommentarer
Datakatalog for datasyn
Det finnes et bredt utvalg av vanlige applikasjoner for Computer Vision i AI-prosjekter. Vi tilbyr deg enorme mengder bilde- og videodata av høy kvalitet som er klare for datasynsmodellene dine som passer budsjettet ditt og kan skaleres etter hvert som du vokser.
Bilde- og videodatakatalog og lisensiering:
- Mat/dokument bildesamling
- Videosamling for hjemmesikkerhet
- Ansiktsbilde/videosamling
- Fakturaer, PO, Kvitteringer Dokumentsamling for OCR
- Bildesamling for deteksjon av kjøretøyskade
- Bildesamling av bilskilt
- Bilinteriør bildesamling
- Bildesamling med bilfører i fokus
- Moterelatert bildesamling
- Dronebasert videosamling og merknad
- Video/bildesamling for funksjonshemmede
- Landmark bildesamling
- Strekkodeskanning bildesamling

Tekstdatakatalog
Store språkmodeller og NLP-systemer trenger tekst som gjenspeiler ekte språk, ekte domener og reell regional variasjon. Vår tekstdatakatalog tilbyr lisensierbare tekstdatasett på tvers av åtte kategorier: samtalebasert spørsmål og svar, kode, nyheter, klinisk, rå netttekst, skannede dokumenter, akademisk og underholdning. De er bygget for forhåndstrening, finjustering, RAG og evaluering, og hver enkelt kan tilpasses prosjektet ditt.
Katalog og lisensiering av ferdige tekstdata:
- 170 000+ menneskeskapte spørsmål og svar-par på engelsk og arabisk, som dekker saudiske, emiratiske, egyptiske og levantinske dialekter
- 50 millioner+ linjer med kode på 9 programmeringsspråk, hvorav flere med full pull-request- og commit-historikk
- Nyhetsarkiv med 975 000 artikler tilbake til 1999, pluss løpende nyhetsstrømmer på engelsk, spansk og arabisk
- Kliniske spørsmål og svar, kasussammendrag og artikler, tilgjengelig som gull-/sølvsett, med de-id.
- 20 millioner ords arabisk råtekstkorpus, pluss tekst- og TTS-skriptkorpus for forhåndstrening
- 1.3 millioner tidsskriftartikler og 4,100+ boktitler på tvers av 12 naturvitenskapelige og ingeniørfag
- Skannede dokumenter og skjemaer fra den virkelige verden (12 000+ PDF-er) for dokument-AI og informasjonsutvinning
- Over 90 000 timer med manusbasert film, TV, animasjon og mikrodramainnhold for narrativ og dialogmodellering
Åpne datasett
Gjennom Shaip-biblioteket med åpne datasett har teamet ditt gratis tilgang til et stort AI-datalager. Nå kan du raskt og nøyaktig utvikle AI- og ML-modellene dine mot dine spesifikke forretningsresultater uten tilknyttede kostnader.
Tilgjengelige åpne datasett:
- Tilgjengelig i en praktisk og modifiserbar form
- Enorme kategorier av datasett
- Gratis for bruk med AI- og ML-prosjektene dine
- Høy kvalitet, gullstandard data

Sikkerhet og samsvar


Planlegg en demo for å lære hvordan Shaip kan oppfylle alle dine treningsdatakrav.
Fra datainnsamling til annotering, lisensiering og validering – vi hjelper deg med å komme raskere ut på markedet, med data du kan stole på.
Kontakt ossOfte stilte spørsmål (FAQ)
1. Hva er datakataloglisensering?
Lisensering av datakataloger lar bedrifter kjøpe eller lisensiere tilgang til kuraterte datasett for bruk i AI-prosjekter. Disse datasettene inkluderer tekst-, tale-, bilde- eller videodata, nøye utarbeidet for å oppfylle spesifikke krav. Lisensiering sikrer at bedrifter lovlig kan bruke dataene samtidig som de overholder personvern- og samsvarsstandarder.
2. Hvordan samles og merkes Shaips AI-treningsdatasett?
Shaip samler inn data gjennom et globalt, verifisert bidragsyternettverk i over 60 land, ved hjelp av Shaips proprietære innsamlingsplattform. Alle datasett gjennomgår flernivåkvalitetssikring av domeneekspertkommentarer, automatiserte valideringskontroller og en endelig gjennomgang med menneskelig tilgang før levering. Målene for merkingsnøyaktighet overstiger 95 % på tvers av alle katalogkategorier.
3. Kan Shaip skalere datasett for å møte økende prosjektbehov?
Ja, Shaips datasett er skalerbare. Enten du trenger små datasett for testing eller store volumer for å trene AI-modeller i bedriftsklassen, kan Shaips globale nettverk levere data som møter prosjektets behov.
4. Hvor mye koster det å lisensiere standard datasett?
Lisenskostnaden avhenger av faktorer som datatype, volum, tilpasning og bruksrettigheter. Shaip tilbyr fleksible priser som passer til ulike budsjetter og prosjektbehov. Kontakt teamet for et personlig tilbud.
5. Kan jeg be om et eksempeldatasett?
Ja, Shaip tilbyr eksempeldatasett som hjelper deg med å vurdere dataenes kvalitet og relevans for prosjektet ditt. Kontakt teamet for å avtale en demonstrasjon eller be om et eksempel.
6. Hvor kan jeg kjøpe lisensierte AI-opplæringsdatasett for kommersiell bruk?
Shaips AI-datakatalog tilbyr forhåndsmerkede datasett tilgjengelig for umiddelbar kommersiell lisensiering på tvers av tekst, tale, bilde, video og multimodale formater. Alle datasett inkluderer tydelig kommersiell lisensdokumentasjon – GDPR- og HIPAA-kompatibel – med alternativer for engangskjøp, årlig abonnement eller bedriftsavtale. Be om en gratis prøve for å validere kvaliteten før kjøp.
7. Hvordan kjøper jeg GDPR- og HIPAA-kompatible datasett for AI-modelltrening?
Shaips komplette datasettkatalog er bygget for å oppfylle kravene i GDPR og HIPAA. Hvert datasett inkluderer samtykkedokumentasjon, avidentifikasjonsregistreringer (for medisinske data), metadata for dataopprinnelse og revisjonsklare samsvarsartefakter. Organisasjoner under GDPR-, HIPAA-, CCPA- eller ISO 27001-rammeverk kan lisensiere datasett med full dokumentasjon inkludert uten ekstra kostnad.
8. Hvilke typer forhåndsmerkede multimodale datasett kan jeg lisensiere fra Shaip?
Shaip tilbyr multimodale datasett som kombinerer tekst-, tale-, bilde- og videodata – inkludert egosentrisk video for fysisk AI, menneskelige demonstrasjonsdatasett for robotikk og kombinerte tekst-bilde-korpora for finjustering av GenAI. Alle multimodale datasett inkluderer metadata, annoteringer på modalitetsnivå og kommersielle lisensvilkår. Gratis eksempler er tilgjengelige på forespørsel.
