Det har lenge vært diskusjoner om hvordan kunstig intelligens (KI) skal endre alle aspekter av menneskeliv, og nå har du sikkert allerede innsett at den har potensial til å bli den mest disruptive teknologien noensinne. I dag kan vi snakke med Siri, Cortana eller Google for å få svar på våre grunnleggende spørsmål, men mye av deres faktiske potensial er ennå ukjent.
Å bygge AI som virkelig forstår menneskelig språk krever mer enn rådata – det krever presisjonsmerkede, språklig ekspertopplæringsdatasett levert i bedriftsskala. Shaip er en ledende NLP-tjenesteleverandør som tilbyr komplette tjenester og løsninger for behandling av naturlig språk for AI-team over hele verden: fra tilpasset innsamling av tekst- og lyddata til ekspertannoteringer, standard NLP-datasett og fullstendig administrert arbeidsstyrkelevering på tvers av over 150 språk.
Enten du trener et konversasjonsbasert AI-system, finjusterer en stor språkmodell (LLM), bygger en sentimentanalysemotor eller skalerer en pipeline for navngitt enhetsgjenkjenning (NER) – Shaips over 30 000 sertifiserte samarbeidspartnere leverer de strukturerte NLP-opplæringsdataene av høy kvalitet som modellene dine trenger for å prestere nøyaktig i den virkelige verden. Shaips NLP-løsninger, som er betrodd av Fortune 500-selskaper innen helsevesen, finans, teknologi og detaljhandel, kombinerer proprietære plattformverktøy, 6 Sigma-kvalitetsprosesser og domeneeksperter for å møte nøyaktighets- og gjennomstrømningskravene til AI i produksjonsklassen.
Enhver høytytende språkmodell starter med spesialbygde, domenespesifikke treningsdata. Shaips NLP-datainnsamlingstjenester skaffer den nøyaktige inndataen modellen din trenger – i volum, på språket ditt og med den språklige variasjonen som kreves i den virkelige verden.
Vi bruker store, tilpassede tekstkorpus på tvers av formater: e-poster, kundeanmeldelser, innlegg på sosiale medier, supportforespørsler, juridiske kontrakter, økonomiske dokumenter og mer. Tekstsamlingstjenestene våre er tilgjengelige på over 150 språk og regionale dialekter, og styrker opplæring i chatboter, finjustering av LLM, søkerelevanssystemer og dokumentforståelsesprosesser.
Fra skriptede instruksjoner til spontan samtale, samler Shaip inn lydopptak av høy kvalitet, skreddersydd til dine ASR- eller stemme-AI-krav – inkludert spesifikke aksenter, støymiljøer, demografiske opplysninger om talere og kanalforhold. Leveres som frittstående samlinger eller som komplette ASR-pakker med transkripsjon, uttaleleksikon og språkspesifikk dokumentasjon for umiddelbar modelltrening. Alle innsamlede data leveres med fulle metadata, talerattribusjon og kvalitetsverifisering gjennom Shaips proprietære annotasjonsplattform.
Nøyaktige NLP-modeller krever nøyaktig annoterte treningsdata. Shaips dataannoteringstjenester kombinerer en autorisert flerspråklig arbeidsstyrke med en proprietær plattform for å levere konsekvent presise etiketter i bedriftsskala – med innebygde kvalitetsporter og transparent leveringssporing.
Våre NLP-annoteringsmuligheter dekker alle større oppgavetyper:
All annotering leveres gjennom en 6 Sigma stage-gate-kvalitetsprosess med samsvarsscoring mellom annotatorer og kontinuerlige tilbakemeldingsløkker.
Bla gjennom vårt lyddatasett med diverse standard NLP-datasett, bestående av over 20 000 timer med lyd, om en rekke emner som kundesenter, generell samtale, debatter, taler, foredrag, dokumentarer, arrangementer, generell samtale, film, nyheter osv., på over 40 språk.
Vi tilbyr en dyktig ressurs som blir en forlengelse av teamet ditt for å støtte dataannoteringsoppgavene dine, gjennom verktøy du foretrekker, samtidig som du opprettholder ønsket kvalitet. Våre erfarne medarbeidere forstår finessene i menneskelige språk og anvender beste praksis som er lært ved å merke millioner av lyd- og tekstdokumenter for å levere datamerkingsløsninger i verdensklasse for naturlig språkbehandling.
Fra tekst-/lydsamling til annoteringer gir vi en bedre forståelse av den talte verden med detaljert, nøyaktig merket tekst og lyd for å forbedre ytelsen til NLP-modellene dine. Enten du trener en virtuell/digital assistent, ønsker å gjennomgå juridiske kontrakter eller bygge en algoritme for økonomisk analyse, tilbyr vi gullstandarddataene du trenger for å få modellene dine til å fungere i den virkelige verden. Teamet vårt forstår språket, dialekten, syntaksen og setningsstrukturen for å merke tekst nøyaktig, basert på dine forretningsbehov.
Vi er et av de få NLP-selskapene som er stolte av sine sterke språklige ferdigheter. Vi har en global arbeidsstyrke på over 30 000 samarbeidspartnere fra hele verden, med ekspertise på over 150 språk . Vi har hjulpet oppstartsbedrifter i tidlig fase, små og mellomstore bedrifter, og jobbet med ledende Fortune 500-selskaper på tvers av ulike vertikaler , f.eks. helsevesen, detaljhandel/e-handel, finans, teknologi og mer, for å nå sine NLP-prosjektmål.
Over 50 XNUMX timer med hyllevaredatasett for lyd/tale for å komme i gang.
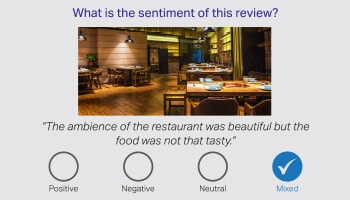
Analyser menneskelige følelser ved å tolke nyanser i kundeanmeldelser, sosiale medier osv.
Samle tekstdatasett, dvs. e-poster, SMS, blogger, dokumenter, forskningsartikler osv.
Opplæring av digitale assistenter krever et stort sett med kvalitetsdata fra forskjellige geografier, språk, dialekter, oppsett og formater. Hos Shaip tilbyr vi opplæringsdata for AI-modeller med Human-in-the-loop som har den nødvendige kunnskapen, domeneekspertisen og er godt klar over de spesifikke behovene til kunden.
Det sies med rette at ord alene ikke klarer å formidle hele historien, og det er menneskelige kommentatorer som har ansvaret for å tolke tvetydigheten i menneskelig språk. Derfor er det ytterst viktig å identifisere følelsen til en kunde, basert på samtalen. Våre språkeksperter fra ulike domener kan tolke nyanser i produktanmeldelser, finansnyheter og sosiale medier.
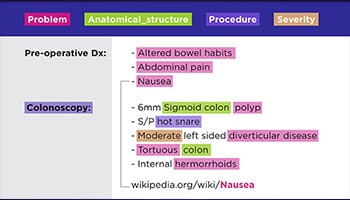
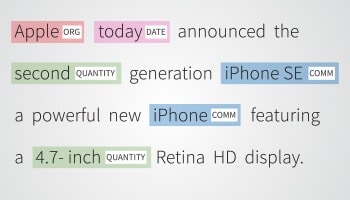
Named Entity Recognition (NER) er å identifisere, trekke ut og klassifisere de navngitte enhetene i en tekst, i forhåndsdefinerte kategorier. Teksten kan kategoriseres som et sted, navn, organisasjon, produkt, mengde, verdi, prosent, osv. Med NER kan du ta opp spørsmål fra den virkelige verden som hvilke organisasjoner som ble nevnt i artikkelen osv.
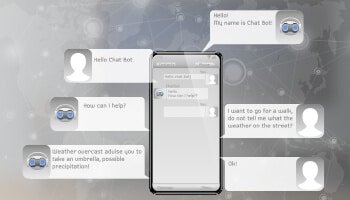
Robuste, godt trente virtuelle chatboter eller digitale assistenter har revolusjonert måten kundene kommuniserer med selgerne på, og har bidratt til en betydelig forbedring i kundeopplevelsen.
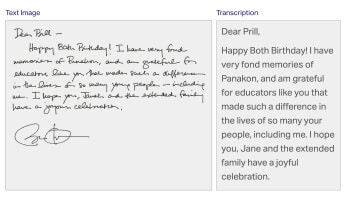
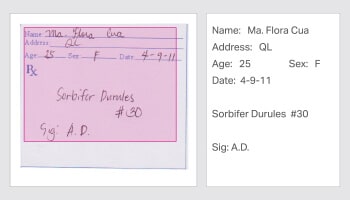
Fra legers håndskrevne resepter til notater fra telefonkonferanser, våre spesialister kan digitalisere alle former for data, f.eks. arkiverte dokumenter, juridiske kontrakter, pasientjournaler, etc.
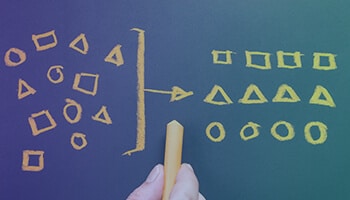
Kategorisering også kjent som klassifisering eller tagging er prosessen med å klassifisere tekst i organiserte grupper og merke den, basert på dens funksjoner av interesse.
Menneskelig evaluering og etterredigering av maskinoversettelsesresultater for å måle flyt, tilstrekkelighet og domenenøyaktighet – muliggjør pålitelige MT-systemer for flerspråklige implementeringer.
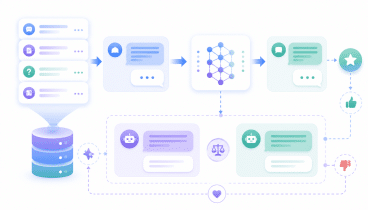
Kuraterte instruksjonsfølgende datasett, prompt-response-par og RLHF-preferansedata for å finjustere og justere store språkmodeller til ditt domene, tone og oppgavekrav.
Annotering av komplekse dokumentstrukturer – kontrakter, medisinske journaler, økonomiske innleveringer – for å trene AI-modeller for dokumenter som trekker ut, klassifiserer og resonnerer over ustrukturert tekst i stor skala.
Emneanalyse eller emnemerking er å identifisere og trekke ut mening fra en gitt tekst ved å identifisere tilbakevendende emner/temaer som vurderes.
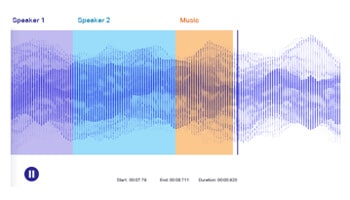
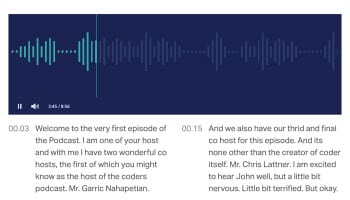
Transkriber tale/podcast/seminar, ring samtale til tekst. Utnytt mennesker til å kommentere lyd-/talefiler nøyaktig for å trene NLP-modeller nøyaktig.
Kategoriser lyder eller ytringer for å klassifisere tale/lyd basert på språk, dialekt, semantikk, leksikon osv.
Vårt utvalg av eksperter som er dyktige i tekst/lydkommentarer/merking kan skaffe nøyaktige og effektivt kommenterte NLP-datasett.
Teamet vårt hjelper deg med å forberede tekst-/lyddata for opplæring av AI-motorer, og sparer verdifull tid og ressurser.
Teamet vårt av samarbeidspartnere kan ta i mot ekstra volum samtidig som kvaliteten på datautdata for NLP-løsningene opprettholdes.
Som eksperter på opplæring og ledelse av team sikrer vi at prosjekter leveres innenfor det definerte budsjettet.
Teamet analyserer data fra flere kilder og er i stand til å produsere AI-treningsdata effektivt og i volum på tvers av alle bransjer.
Det brede spekteret av lyd-/tekstdata gir AI store mengder informasjon som trengs for å trene raskere.
Dedikerte og trente team:
Høyeste prosesseffektivitet er sikret med:
Den patenterte plattformen tilbyr fordeler:
AI chatbots gir forbedret brukeropplevelse ved å lære av tidligere interaksjoner, forstå brukeratferd og forstå forskjellige språk ved å bruke avanserte beslutningsferdigheter.
Automatisk talegjenkjenning (ASR) har kommet langt. Selv om det ble oppfunnet for lenge siden, ble det nesten aldri brukt av noen. Imidlertid har tid og teknologi nå endret seg betydelig.
Det globale markedet for naturlig språkbehandling er beregnet til å øke fra 1.8 milliarder dollar i 2021 til 4.3 milliarder dollar i 2026, og vokse med en CAGR på 19.0 % i løpet av perioden.
Gir teamene mulighet til å bygge verdensledende AI-produkter.
NLP er en gren av kunstig intelligens som gjør det mulig for maskiner å forstå, analysere og respondere på menneskelig språk, både tekst og tale, ved å tolke kontekst, følelser og intensjon.
NLP innebærer behandling av menneskelig språk ved hjelp av algoritmer som analyserer grammatikk, syntaks, semantikk og kontekst. Den er avhengig av store mengder kommenterte data for å trene AI-modeller til å trekke ut mening, identifisere mønstre og generere nøyaktige svar.
NLP brukes i applikasjoner som virtuelle assistenter, chatboter, sentimentanalyse, maskinoversettelse, tekstoppsummering, spamdeteksjon og grammatikkorrigering. Det driver systemer som gjør menneske-maskin-interaksjoner mer effektive og naturlige.
NLP-tjenester inkluderer tekstinnsamling (innhenting av diverse tekstdata), lydinnsamling (opptak av taledata), dataannotering (merking av tekst og lyd for trening av AI) og transkripsjon (konvertering av tale til tekst for analyse).
NLP-løsninger forbedrer AI-modeller ved å tilby nøyaktig merkede datasett som hjelper modellene med å forstå menneskelig språk bedre. Dette forbedrer oppgaver som sentimentanalyse, navngitt enhetsgjenkjenning (NER), konversasjonsbasert AI og chatbot-trening.
Viktige bransjer inkluderer helsevesen (analyse av medisinske journaler og pasientsentiment), finans (svindeloppdagelse og dokumentanalyse) og e-handel (personlige anbefalinger og automatisering av kundesupport).
Tidslinjene varierer basert på prosjektets størrelse og kompleksitet, men er optimalisert for å levere data av høy kvalitet effektivt.
Kvalitet garanteres gjennom strenge valideringsprosesser, ekspertkommentarer og avanserte verktøy, som sikrer at dataene oppfyller de høyeste standardene.
Kostnadene avhenger av faktorer som prosjektets omfang, datakompleksitet og tilpasningsbehov. Kontakt Shaip for et personlig tilbud basert på dine behov.
NLP som en tjeneste refererer til en fullstendig administrert dataleveringsmodell der en NLP-tjenesteleverandør håndterer alle trinn i språkdataprosessen din – innsamling, annotering, kvalitetssikring og levering – på dine vegne. Shaip tilbyr prosjektbaserte, abonnementsbaserte og innebygde teamleveringsmodeller som passer til ulike organisasjonsbehov og prosjektskalaer.
Hver språkpool består av morsmålstalende eller nesten-morsmålstalende som er rekruttert og screenet for domenekunnskap. Annotasjoner kalibreres mot gullstandardreferansesett, og en 6 Sigma-kvalitetsprosess med samsvarsvurdering mellom annotatorer sikrer konsistens på tvers av alle språkpar og dialekter.
Shaip driver HIPAA-bevisste arbeidsflyter for NLP-prosjekter innen helsevesenet og samsvarer med GDPR-kravene til samtykkehåndtering for datainnsamling i EU. Alle prosjekter inkluderer dokumentasjon av revisjonsspor, dataopprinnelsesregistreringer og rollebaserte tilgangskontroller for samsvarsteam i bedrifter.
Ja. Shaip leverer instruksjonsfølgende datasett, prompt-response-par og RLHF-preferansedata for finjustering og justering av LLM. Vår side om generative AI-løsninger dekker hele omfanget av LLM-opplæringsdatatjenester.
Datainnsamling innebærer å hente inn råtekst eller lyd – inndatamaterialet modellen din skal lære av. Annotering innebærer å merke disse rådataene med strukturerte tagger, kategorier, enheter eller sentimentindikatorer som forteller modellen hva den skal forstå. Shaip tilbyr både som frittstående tjenester eller som en integrert ende-til-ende NLP-dataløsning.
Ja. Shaip har jobbet med oppstartsbedrifter i tidlig fase, små og mellomstore bedrifter og Fortune 500-bedrifter. Vi tilbyr fleksibel prosjektomfang, minimum levedyktige datasettpakker for MVP-stadiet av kunstig intelligens og skalerbare leveringsmodeller som vokser med dine annoteringsbehov. Kontakt oss for et tilpasset tilbud.
Vi bruker informasjonskapsler for å forbedre opplevelsen din på nettstedet vårt. Ved å bruke nettstedet vårt samtykker du til informasjonskapsler.
Administrer informasjonskapselpreferansene dine nedenfor:
Viktige informasjonskapsler aktiverer grunnleggende funksjoner og er nødvendige for at nettstedet skal fungere riktig.
Google Tag Manager forenkler administrasjonen av markedsføringstagger på nettstedet ditt uten kodeendringer.
Statistikkinformasjonskapsler samler inn informasjon anonymt. Denne informasjonen hjelper oss å forstå hvordan besøkende bruker nettstedet vårt.
Google Analytics er et kraftig verktøy som sporer og analyserer nettstedstrafikk for å ta informerte markedsføringsbeslutninger.
Tjeneste-URL: policies.google.com (åpnes i et nytt vindu)
Markedsføringsinformasjonskapsler brukes til å følge besøkende til nettsider. Hensikten er å vise annonser som er relevante og engasjerende for den enkelte bruker.
Google Ads er en nettbasert annonseringsplattform som lar bedrifter lage målrettede annonser som vises i Googles søkeresultater og partnersider.
Tjeneste-URL: policies.google.com (åpnes i et nytt vindu)
HubSpot er en alt-i-ett-plattform for markedsføring, salg og kundeservice som effektiviserer forretningsvekst.
Tjeneste-URL: legal.hubspot.com (åpnes i et nytt vindu)
Du finner mer informasjon i våre retningslinjer for informasjonskapsler og personvernregler.