Bygg apper som alltid lytter med tilpassede treningsdata for vekkeord. Høyere deteksjonsnøyaktighet, færre falske aktiveringer.
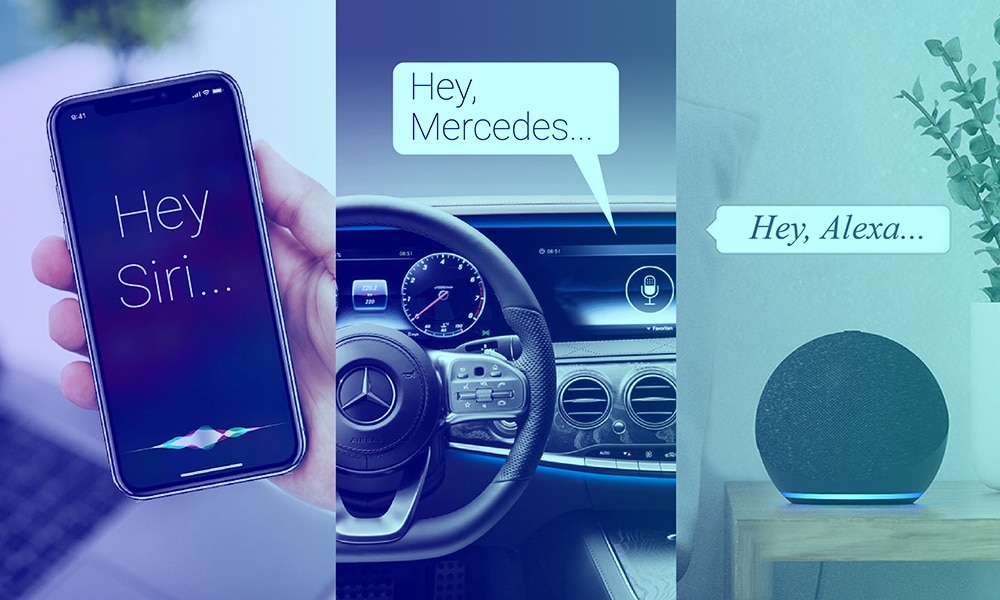
Taleassistenter har dramatisk forandret måten kundene samhandler med enhetene sine på. De har gjort det enklere for brukere å utforske produkter og tjenester – raskt og effektivt. Men lytter taleapplikasjonen? For å sette disse applikasjonene i høy drift, må de vekkes og gå over fra passiv til aktiv lytting ved hjelp av WAKE WORDS. "Alexa" og "Hei Siri" er to av de mest populære våkne ordene i verden.
Innen 2024 forventes antallet digitale stemmeassistenter å nå 8.4 milliarder enheter – mer enn verdens befolkning.
Markedet for stemmeassistentapper forventes å øke fra 2.8 milliarder dollar i 2021 til 11.2 milliarder dollar i 2026, med en årlig vekstrate (CAGR) på 32.4 %.
Et vekkeord er et spesifikt ord eller en frase, som for eksempel «Hei Siri», «Ok Google» og «Alexa»; designet for å aktivere en stemmeaktivert enhet til å svare når den ytres. Et vekkeord som alltid lytter og er lokalt integrert med enheten, reduserer imidlertid responstiden drastisk og øker nøyaktigheten av identifiseringen og behandlingen av vekkeordet, selv uten internettforbindelse. Shaip samler inn treningsdata for vekkeord på tvers av over 100 språk, forskjellige aksenter, aldersgrupper og støymiljøer i den virkelige verden for å maksimere nøyaktigheten av deteksjon og minimere falske aktiveringer. De er også kjent som:
Med Shaips tilbyr alltid lyttende våkneord-trening, er stemmeassistentmodellene dine alltid innstilt til å lytte etter våkneordet, men uten å ta opp eller overføre data til skyen. Å samarbeide med Shaip gir deg fordelen av å jobbe med eksperter. Med vår omfattende erfaring med bruk av AI- og ML-teknologi i utvikling av taleassistentopplæring, hjelper vi deg med å eliminere personvernrisiko, forbedre brukeropplevelsen, redusere utviklingskostnader og forbedre skalerbarheten.
Shaip bygger treningsdata for fullstendig merkevarebaserte «wake words», slik at kundene sier merkenavnet ditt – ikke en generisk assistent. Hvert datasett er justert til den nøyaktige aktiveringsfrasen din, noe som forsterker merkevaregjenkjenningen med hver interaksjon og holder taleopplevelsen innenfor ditt eget økosystem.
Shaip støtter alltid-lyttende oppvåkningsordmodeller som kjører på enheten uten å ta opp eller overføre lyd til skyen. Opplæringsdata for oppvåkningsord på enheten reduserer ventetid, reduserer personvernrisiko og sørger for at deteksjonen fungerer pålitelig selv uten internettforbindelse.
Shaip samler inn «wake words»-ytringer på tvers av over 100 språk og regionale aksenter – skotsk, kanadisk, australsk, indisk engelsk og flere – slik at nøyaktigheten av deteksjonen gjelder på tvers av globale brukerbaser i stedet for å bli dårligere for ikke-morsmålstalende.
Shaip fanger opp data om vekkeord under stille, støyende forhold, i bil, utendørs og på avstand. Trening på akustisk variasjon i den virkelige verden reduserer falske avvisninger når brukere snakker på avstand eller i bakgrunnsstøy.
Utover det såkalte «wake word», tilbyr Shaip data om ytringer og frasegjenkjenning, slik at enheter behandler lengre kommandoer i naturlig språk med lav latens. Innebygde data for nøkkelordgjenkjenning støtter prosessering i nettleseren og på brikken for høy nøyaktighet og personvern.
Ulike fonemer skaper generelt en mer distinkt signatur og sikrer bedre nøyaktighet i resultatene. Velg derfor fraser i dataene dine som produserer forskjellige lyder.
Gjør vekkeord mer effektive ved å sette på dem med prefikser som «Hei», «Hei», «Hei» eller «OK». Det vil holde våkneordet entydig og sikre at ingen tilfeldig samsvar oppstår når du bruker triggerord i vanlig tale.
Gjør dine våkne ord til en kombinasjon av minst seks fonemer som er lett gjenkjennelige av en maskin og enkle å si av mennesker. For eksempel har "Alexa" seks fenomener mens "Ok Google" har åtte fenomener.
Ikke gjør den feilen å bruke et enkelt ord som våkenord. Wake-ord må være lange nok til å være distinkte.
Sørg for at utløserordene du lager må være enkle og unike, slik at de lett kan huskes.
Lengre våknefraser med flere ord er vanskelig å uttale og gjør prosessen unødvendig vanskeligere.
En wake word-modell er generelt opplært til å gjenkjenne et nei. av forskjellige ytringer, slik at den kan svare på forskjellige påkallelser. Men å ha for mange distinkte våkne ord kan ganske enkelt aktivere talerørledningen uten at du vet hvilken ytring brukeren sa.
Faktorer som støy, avstand og variasjoner i aksenter og språk gjør nøyaktig gjenkjenning av kommandoord vanskeligere og komplekst for AI-modellen din.
Vår erfaring innen stemmeteknologi hjelper oss raskt å utvikle skreddersydde wake-ord og merkede wake-fraser som alltid lytter. Med stemmegjenkjenning i takt med naturlig språkbehandlingsforståelse, hjelper ML-algoritmer å transkribere tale og utføre talekommandoer effektivt.
Vi fokuserer på å raskt utvikle wake word-prototyping for å sikre tilpasning av merkeordet. En prototype fungerer som et proof of concept og hjelper til med nøyaktig opplæring, raskere tid til markedet, akselerert testing og eliminering av risiko.
Opplev uavbrutt vekst og uhindret kundeengasjement med en eksepsjonell stemmeassistent. Vi tilbyr flerspråklige talegjenkjenningsfunksjoner slik at applikasjonen nøyaktig kan oppdage ord og setninger selv i miljøer med mye støy.
Det er en måte å samle inn viktige brukerdata på som identitet, opprinnelsesland, alder, kjønn, språk, aksenter osv. Datamangfold brukes til å forbedre brukerorienterte algoritmer for å oppnå mer nøyaktige resultater.
Data har vanligvis en tendens til å generere innebygde skjevheter. Derfor, når vi samler inn data fra ulike kilder, reduseres skjevheten i resultatene betydelig.
Her er noen parametere for datamangfold som Shaip adresserer mens han bygger våkneord og andre samtalekommandoer.
| Ras og etnisitet | Hindu, muslim, kristen, afrikaans, europeere |
| Utdanningsnivå | Undergraduate, Graduate, Ph.D., Masters |
| Land | Kina, Japan, India, Korea, Dubai, Nigeria, USA, Canada |
| Kjønn | Mann Kvinne |
| Alder | Under 10 år, 10–15, 15–25, 25–45, 45 år og over |
| Språk | Engelsk, japansk, tyrkisk, kinesisk, thai, hindi |
| Miljø | Stille, Støyende, Bakgrunnsmusikk, Bakgrunnslyd/tale, Innendørs, Utendørs, Teater, Stadion, Kafeteria, I bil, Kontor, Kjøpesenter, Hjemmestøy, Trapp, Gate/vei, Sjøside (vindfull) |
| Aksenter (engelsk) | Skotsk engelsk, walisisk engelsk, hiberno-engelsk, kanadisk engelsk, australsk engelsk, newzealandsk engelsk |
| Snakker stil | Rask/Normal/Langsom hastighet, Høy/Normal/Lavt volum, Formell/Uformell |
| Enhetsposisjoner | Håndholdt, stasjonær |
Vekkeorddata for høyttalere, TV-er og apparater som må aktiveres umiddelbart og avvise bakgrunnsstøy.
Fjernfelts, støyrobuste datasett med våkneord for håndfrie assistenter i kabinen.
Lavt fotavtrykk av «wake word»-data for enheter som alltid er på og har begrenset batterikapasitet.
Tilpassede data om vekkeord og ytringer for å lokalisere assistenter på tvers av språk og dialekter.
Personvern først, vekkeorddata på enheten for håndfrie kliniske og pasientinnstillinger.
Multimodale vekkeord- og kommandodata for roboter som reagerer i sanntid uten skyen.
Shaip samarbeider med deg for å velge et fonetisk distinkt, merkevaretilpasset «wake word» og definere retningslinjer for innsamling.
Shaips globale arbeidsstyrke registrerer «wake word» på tvers av nødvendige språk, aksenter, aldre, enheter og støyende miljøer.
Hver ytring blir transkribert, merket og kvalitetssjekket mot dine akseptkriterier.
Shaip leverer strukturerte, policykontrollerte treningsdata for wake words formatert for modellpipeline.
For å implementere AI-initiativet ditt effektivt, trenger du store mengder spesialiserte opplæringsdatasett. Shaip er et av svært få selskaper på markedet som sikrer pålitelige opplæringsdata i verdensklasse i stor skala som overholder regulatoriske/GDPR-krav.
Lag, kurater og saml spesialbygde datasett (tekst, tale, bilde, video) fra over 100 nasjoner over hele verden basert på tilpassede retningslinjer.
Utnytt vår globale arbeidsstyrke på 30,000 XNUMX+ erfarne og akkrediterte bidragsytere. Fleksibel oppgavetildeling og sanntids arbeidsstyrkekapasitet, effektivitet og fremdriftsovervåking.
Vår proprietære plattform og dyktige arbeidsstyrke bruker flere kvalitetskontrollmetoder for å møte eller overgå kvalitetsstandarder satt for innsamling av AI-treningsdatasett.
Prosessen vår effektiviserer innsamlingsprosessen gjennom enklere oppgavedistribusjon, administrasjon og datafangst direkte fra appen og nettgrensesnittet.
Oppretthold fullstendig datakonfidensialitet ved å gjøre personvernet til vår prioritet. Vi sikrer at dataformater er policykontrollert og bevart.
Utvalgte domenespesifikke data samlet inn fra bransjespesifikke kilder basert på retningslinjer for innsamling av kundedata.
Shaip tilbyr ende-til-ende tale-/lyddatainnsamlingstjenester på over 150+ språk for å muliggjøre stemmeaktiverte teknologier for å imøtekomme et mangfoldig sett av publikum over hele verden.
Chatboten du snakket med kjører på et avansert AI-system for samtale som er trent, testet og bygget ved hjelp av tonnevis av talegjenkjenningsdatasett. Det er den grunnleggende prosessen bak teknologien som gjør maskiner intelligente
Behovet for Utterance-trening oppstår fordi ikke alle kunder bruker de nøyaktige ordene eller setningene mens de samhandler eller stiller spørsmål til stemmeassistentene sine i et skriptformat.
Gir teamene mulighet til å bygge verdensledende AI-produkter.
Et vekkeord er et spesifikt ord eller uttrykk – for eksempel «Alexa», «Ok Google» eller en tilpasset merkevarefrase – som aktiverer en stemmeaktivert enhet og bytter den fra passiv til aktiv lytting. Enheten lytter kontinuerlig lokalt etter vekkeordet og begynner først å behandle en forespørsel når vekkeordet er oppdaget.
Data om trening av vekkeord er det merkede settet med talte opptak som brukes til å lære en modell å gjenkjenne aktiveringsfrasen sin. Effektive data om trening av vekkeord spenner over mange talere, aksenter, aldre, enheter og støyforhold, slik at modellen utløses pålitelig samtidig som den avviser tale som høres lignende ut.
Et vekkeord fungerer ved å kjøre en liten, alltid-lyttende deteksjonsmodell som skanner innkommende lyd for målfrasen. Når modellen samsvarer med vekkeordet med tilstrekkelig sikkerhet, aktiveres enheten og begynner å behandle brukerens forespørsel ved hjelp av talegjenkjenning og naturlig språkbehandling.
Et sterkt, tilpasset «vekkeord» bruker forskjellige fonemer, inneholder minst tre til fire stavelser og unngår vanlige hverdagsord for å redusere falske aktiveringer. Å legge til et prefiks som «Hei» eller «OK» forbedrer særpreg. Shaip hjelper med å velge og validere «vekkeord» under prosjektoppsettet.
Ja. Aktiveringsmodellen kjøres lokalt av «wake word detection» på enheten, slik at lyd ikke tas opp eller sendes til skyen. Dette reduserer ventetiden, beskytter personvernet og sørger for at deteksjonen fungerer offline. Shaip samler inn treningsdata som er spesielt egnet for distribusjon på enheten og innebygd.
Shaip samler inn data om trening av vekkeord på over 100 språk og et bredt spekter av regionale aksenter, hentet fra en global arbeidsstyrke i over 100 land. Denne bredden reduserer nøyaktighetsforskjeller for ikke-morsmålstalende og støtter globale produktlanseringer.
Shaip bruker flere kvalitetskontroller – transkripsjonsgjennomgang, akseptkriterier og arbeidsstyrkeovervåking – slik at datasettene oppfyller målnøyaktigheten før levering. Mangfoldige data av høy kvalitet reduserer både falske aksept- og falske avvisningsrater i den distribuerte modellen.
Et «vekkeord» aktiverer enheten; en ytring er den talte forespørselen som følger. Deteksjon av «vekkeord» er en smal oppgave som alltid er på, mens forståelse av ytringer innebærer å tolke variert frasering i naturlig språk. Shaip tilbyr treningsdata for både deteksjon av «vekkeord» og innsamling av ytringer.
En ytring er en frase en bruker sier for å sende en forespørsel til talekommandoprogramvare. Programvaren identifiserer brukerens intensjon fra ytringen og svarer deretter. I motsetning til en fullstendig setning er en ytring en taleenhet som kanskje ikke formidler en fullstendig tanke og ofte inneholder pauser. Eksempler: «Vis meg den nyeste filmen – den som ble utgitt forrige uke», eller «Er butikken i 22nd Street åpen nå?»
Et kallenavn er nøkkelordet som brukes til å utløse en spesifikk «ferdighet» i taleprogramvare. Det kan inneholde navn på personer eller steder og kombineres med en handling, kommando eller spørsmål. Hver tilpasset ferdighet trenger et kallenavn for å starte den.
Vekkeord kalles også triggerord, varme ord, aktiveringsord, påkallelsesord, vekkefraser og ytringer.
Alexa bruker flere innebygde mikrofoner for å oppdage sitt «wake word» samtidig som den filtrerer ut bakgrunnsstøy. For å forhindre falske positiver og negative resultater, begynner den først aktiv lytting etter at den har oppdaget «Alexa».
Vi bruker informasjonskapsler for å forbedre opplevelsen din på nettstedet vårt. Ved å bruke nettstedet vårt samtykker du til informasjonskapsler.
Administrer informasjonskapselpreferansene dine nedenfor:
Viktige informasjonskapsler aktiverer grunnleggende funksjoner og er nødvendige for at nettstedet skal fungere riktig.
Google Tag Manager forenkler administrasjonen av markedsføringstagger på nettstedet ditt uten kodeendringer.
Statistikkinformasjonskapsler samler inn informasjon anonymt. Denne informasjonen hjelper oss å forstå hvordan besøkende bruker nettstedet vårt.
Google Analytics er et kraftig verktøy som sporer og analyserer nettstedstrafikk for å ta informerte markedsføringsbeslutninger.
Tjeneste-URL: policies.google.com (åpnes i et nytt vindu)
Markedsføringsinformasjonskapsler brukes til å følge besøkende til nettsider. Hensikten er å vise annonser som er relevante og engasjerende for den enkelte bruker.
Google Ads er en nettbasert annonseringsplattform som lar bedrifter lage målrettede annonser som vises i Googles søkeresultater og partnersider.
Tjeneste-URL: policies.google.com (åpnes i et nytt vindu)
HubSpot er en alt-i-ett-plattform for markedsføring, salg og kundeservice som effektiviserer forretningsvekst.
Tjeneste-URL: legal.hubspot.com (åpnes i et nytt vindu)
Du finner mer informasjon i våre retningslinjer for informasjonskapsler og personvernregler.