Tjenester for innsamling av bildedata for datasyn
Tilpassede, fullt godkjente bildedatasett – ethvert motiv, ethvert scenario, bygget etter modellens spesifikasjoner.
Hvorfor er bildeopplæringsdatasett nødvendig for datasyn?
Innsamling av bildedata er prosessen med å fange, finne og kuratere bildedatasett for å trene modeller for datasyn og maskinlæring. Shaip samler inn tilpassede, fullt godkjente bilder – på tvers av ansikter, dokumenter, objekter, scener og medisinske bilder – skreddersydd til hver modells domene, oppløsning og demografiske krav, og kvalitetskontrollerer deretter hvert bilde gjennom en Six Sigma-prosess.
Smarte ML-modeller og oppsett som har i oppgave å identifisere objekter og mønstre som en del av deres funksjon, må trenes grundig. Fra å spore interaksjoner til menneskelige følelser, må intelligente systemer ha grunnlaget for å identifisere enheter i utgangspunktet. Kraften til identifisering leveres av tilpassede bildedatainnsamlingsløsninger.
Innsamling av bildedata for datasynssystemer kommer med følgende fordeler:
- Unikt bildespesifikt depot
- Evne til å merke bilder i henhold til krav
- Tilgang til lastebillass med historiske data
Datasett for profesjonell bildetrening
Hvilket som helst emne. Ethvert scenario.
Applikasjoner som trenger ansikts- og gestaltagging kan ikke mates med informasjon, overfladisk. I stedet må innsamling av bildedata for maskinlæringsmodeller være på nivå med de nyeste standardene. Hos Shaip fokuserer vi på å gi tilgang til omfattende bildeopplæringsdatasett med støtte på ekspertnivå mot skalerbarhet.
Profesjonelle bildedatasett hos Shaip fokuserer på omfattende løsninger, inkludert enhetssporing, håndskriftanalyse, objektidentifikasjon og mønstergjenkjenning. Det er ikke alt! Bildedatainnsamlingstjenester som tilbys av Shaip inkluderer også:
- Ekstern og in-field datamating
- Evne til å skalere løsninger – kontinuerlig datasettinnkjøp
- Høykvalitets og segmenterte data som er klare for gruvedrift
- Støtte for bilde-til-tekst-transkripsjon for OCR trente modeller
- Omfattende støtte for menneskespesifikk analyse
- Sikker datahåndtering og administrasjon
Vår ekspertise
Bildesamling som går foran emner og scenarier
Hos Shaip har vi et helt utvalg av bildedatainnsamlingstyper, med algoritmer synonymt med spesifikke brukstilfeller. Legg datasyn til maskinlæringsmulighetene dine ved å samle inn store mengder bildedatasett (medisinsk bildedatasett, fakturabildedatasett, ansiktsdatasett eller et hvilket som helst tilpasset datasett) for en rekke brukstilfeller. Hos Shaip har vi et helt utvalg av bildedatainnsamlingstyper, med algoritmer synonymt med spesifikke brukstilfeller. Ulike typer bildedatasett som vi tilbyr:
Dokument- og OCR-bildesamling
Shaip registrerer fakturaer, kvitteringer, ID-er, pass og håndskrevne skjemaer for OCR og dokumentforståelsesmodeller, på flere språk og med flere registreringsbetingelser. Brukstilfelle: OCR, KYC, dokumentklassifisering.
Samling av ansikts- og demografiske bilder
Shaip samler inn ansiktsbildedatasett på tvers av etnisiteter, aldre, hodestillinger og belysning for å redusere AI-skjevhet, med alternativer for landemerkepunkter for gjenkjenning og følelsesmodeller. Brukstilfelle: ansiktsgjenkjenning, følelses-AI, ADAS-driverovervåking.
Innsamling av helsedata
Forbedre kvaliteten på det digitale helsevesenet ditt og nøyaktigheten av medisinsk diagnostikk med kvalitative og kvantitative helsedatasett som tilbys. Vi leverer medisinske bilder dvs. CT-skanning, MR, ultralyd, røntgen fra ulike medisinske spesialiteter som radiologi, onkologi, patologi, etc.
Innsamling av matdatasett
Hvis du noen gang planlegger å utvikle en smart app som kan fange og identifisere matbilder, under forskjellige lysforhold, kan samlingen vår med matdatasett være ganske nyttig.
Innsamling av bildata
Trening av databasene for selvkjørende biler med veikantelementer, vinkelspesifikke innsikter, objekter, sematiske data og mer er mulig med datasett for biler.
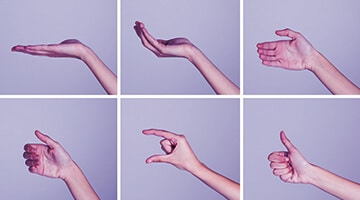
Håndbevegelsesdatainnsamling
Hvis du noen gang har håndsveipt mobilen din for å sove, ville du vært i stand til å relatere. Smarte og IoT-enheter med sensorer kan dra nytte av våre datainnsamlingstjenester for håndbevegelser.
Objektbildesamling
Vår tjeneste for innsamling av objektbilder gir et bredt utvalg av bilder med ulike objekter i ulike sammenhenger og lysforhold.
Landmark bildesamling
Vi er spesialister på å samle inn bilder av landemerker fra hele verden. Våre datasett dekker flere vinkler, tider på dagen og værforhold
Håndskrevet tekstsamling
Samling av håndskrevne tekstbilder på forskjellige språk og stiler for å utvikle AI-modeller som er i stand til å gjenkjenne og tolke håndskrevet tekst med nøyaktighet.
Bildedatasett
Bilfører i fokus Bildedatasett
450 20,000 bilder av sjåføransikter med biloppsett i forskjellige positurer og variasjoner som dekker 10 XNUMX unike deltakere fra XNUMX+ etnisiteter
- Bruk sak: ADAS-modell i bilen
- Format: Bilder
- Volum: 455,000 +
- merknad: Nei
Landmerke bildedatasett
Mer enn 80 40 bilder av landemerker fra over XNUMX land, samlet basert på tilpassede krav.
- Bruk sak: Landmerkegjenkjenning
- Format: Bilder
- Volum: 80,000 +
- merknad: Nei
Datasett for ansiktsbilder
12k bilder med variasjoner rundt hodeposisjon, etnisitet, kjønn, bakgrunn, fangstvinkel, alder osv. med 68 landemerkepunkter
- Bruk sak: ansiktsgjenkjenning
- Format: Bilder
- Volum: 12,000 +
- merknad: Merkemerke
Matbildedatasett
55 50 bilder i XNUMX+ varianter (wrt mattype, belysning, innendørs vs utendørs, bakgrunn, kameraavstand osv.) med kommenterte bilder
- Bruk sak: Matgjenkjenning
- Format: Bilder
- Volum: 55,000 +
- merknad: Ja
Hvordan det fungerer / Prosess
Omfang og spesifikasjoner
Definer emne, volum, steder, demografi, formater og samtykkekrav.

Pilot og kalibrering
Kjør et lite pilotprosjekt for å validere retningslinjer og kanttilfeller før skalering.
Fullskala samling
Fang opp i store mengder gjennom Shaips godkjente globale bidragsyternettverk.

Six Sigma QA
Flertrinnsvalidering, gulloppgaver og samsvarskontroller på hver batch.
Levering og påfyll
Lever i ditt eget format med metadata, og utvid deretter dekningen etter behov.
Hvorfor velge Shaip
Tilpasset, ikke skrapet: Shaip samler inn ferske, fullt godkjente bilder i henhold til dine eksakte spesifikasjoner – domene, oppløsning og demografisk miks – i stedet for å pakke offentlige sett på nytt.
Six Sigma-kvalitet: Et dedikert team med Six Sigma-svarte belter kjører en fase-til-fase QA-prosess med kontinuerlige tilbakemeldingsløkker, slik at datasettene sendes validert.
Skjevhetsbevisst dekning: Shaip-kilder på tvers av etnisiteter, aldre, geografiske områder og lysforhold for å redusere visuell AI-skjevhet på datalaget.
Tjenester tilbys
Eksperttekstdatainnsamling er ikke alt på dekk for omfattende AI-oppsett. Hos Shaip kan du til og med vurdere følgende tjenester for å gjøre modellene mye mer utbredt enn vanlig:

Lyddatainnsamlingstjenester
Vi gjør det enklere for deg å mate modellene med stemmedata for å hjelpe dem med å utforske fordelene ved naturlig språkbehandling på en mer balansert måte

Tekstdatainnsamlingstjenester
Den sanne verdien av Shaip kognitive datainnsamlingstjenester er at det gir organisasjoner nøkkelen til å låse opp kritisk informasjon som finnes i ustrukturerte data

Videodatainnsamlingstjenester
Fokuser nå på datasyn sammen med NLP for å trene modellene dine til å identifisere objekter, individer, avskrekkende midler og andre visuelle elementer til perfeksjon
Anbefalte ressurser
Kjøperhåndbok
Bildemerking og merking for datasyn
Datasyn handler om å forstå den visuelle verdenen for å trene datasynsapplikasjoner. Suksessen koker fullstendig ned til det vi kaller bildekommentarer – den grunnleggende prosessen bak teknologien som får maskiner til å ta intelligente avgjørelser, og det er akkurat dette vi er i ferd med å diskutere og utforske.
Løsninger
Datasynstjenester og -løsninger
Datasyn er et område innen kunstig intelligens-teknologi som trener maskiner til å se, forstå og tolke den visuelle verden, slik mennesker gjør. Det bidrar til å utvikle maskinlæringsmodeller for å forstå, identifisere og klassifisere objekter i et bilde eller en video nøyaktig – i mye større skala og med mye større hastighet.
Blogg
Bildemerknadstyper: Fordeler, ulemper og brukstilfeller
Verden har ikke vært den samme helt siden datamaskiner begynte å se på objekter og tolke dem. Fra underholdende elementer som kan være så enkle som et Snapchat-filter som produserer et morsomt skjegg i ansiktet ditt til komplekse systemer som autonomt oppdager tilstedeværelsen av små svulster fra skannerapporter, spiller datasyn en stor rolle i menneskehetens utvikling.
Utvalgte klienter
Gir teamene mulighet til å bygge verdensledende AI-produkter.
Vil du bygge ditt eget bildedatasettlager?
Få et fugleperspektiv på bildetreningsdatasett og skaff deg et oppbevaringssted for Computer Vision-modellen din.
Ofte stilte spørsmål (FAQ)
Innsamling av bildedata for AI/ML er prosessen med å samle visuelle data – fotografier, skanninger eller grafikk – for å trene, teste og validere maskinlæringsmodeller som tolker bilder. De innsamlede bildene gir datasynssystemer eksemplene de trenger for å gjenkjenne objekter, ansikter, scener og mønstre nøyaktig under virkelige forhold.
Innsamling av bildedata starter med å definere et prosjekts krav og mål. Bilder hentes deretter fra databaser, tas nylig med kameraer eller genereres etter behov, med mangfold og kvalitet som prioriteter. Når bildene er samlet inn, merkes eller annoteres de vanligvis for å legge til konteksten og klassifiseringen en maskinlæringsmodell er avhengig av under trening.
Innsamling av bildedata er grunnleggende for ethvert maskinlæringsprosjekt som omhandler visuell informasjon. Kvalitetsmessig mangfoldige bildedatasett gir mer nøyaktig og robust modelltrening, noe som fører til sterkere ytelse i den virkelige verden. Godt innsamlede data sikrer at AI-systemer kan gjenkjenne, tolke og reagere på visuelle signaler pålitelig under de forholdene de vil møte i produksjonen.
Mange typer kan samles inn avhengig av målet, inkludert fotografier, satellittbilder, håndskrevne og skannede dokumenter, ansiktsfotografier, termiske bilder og AR/VR-opptak. Typen som hentes inn bør samsvare med de spesifikke kravene til AI/ML-prosjektet, siden domenesamsvar direkte påvirker modellens nøyaktighet.
Tilpasset samling fanger opp ferske, fullt godkjente bilder som samsvarer med modellens domene, oppløsning og demografiske behov. Offentlige datasett som ImageNet eller COCO er generiske og får ofte bare en modell til prototypestadiet. Shaip samler inn nøyaktig etter dine spesifikasjoner, slik at dataene gjenspeiler de reelle forholdene, subjektene og kanttilfellene applikasjonen din må håndtere.
Shaip anvender en Six Sigma stage-gate kvalitetsprosess, ledet av dedikerte prosesseiere med svart belte, med validering og tilbakemeldingsløkker på hver batch. For å redusere visuell AI-skjevhet på datalaget, bruker Shaip kildekode på tvers av etnisiteter, aldre, geografiske områder og lysforhold, slik at modellene yter rettferdig og konsistent i stedet for å skjevvride mot overrepresenterte grupper.
Ja. Shaip samler inn bildedata gjennom fullt samtykke fra kildekode med dokumenterte deltakerfritak og sikker, tilgangskontrollert håndtering og overføring. Dette er viktig for kommersiell bruk, der tvetydig lisensierte offentlige bilder skaper juridisk risiko.
Kostnaden avhenger av bildevolum og -type, målregioner, nødvendige metadata og samtykkekrav, så det er ingen fast pris. Shaip gir et tilpasset tilbud etter en kort samtale om omfanget av emnet, spesifikasjonene og tidslinjen, noe som hindrer deg i å betale for et samlingsomfang som modellen din faktisk ikke trenger.