NER-annotasjonstjenester

Annotasjonstjenester og tilpassede datasett for navngitt enhetsgjenkjenning (NER)

Nøyaktig, human-in-the-loop-enhetsannotering for NLP-, LLM- og RAG-opplæring – sikker, skalerbar og levert på over 60 språk.

Navngitt enhetsgjenkjenning
Globalt godkjente bidragsytere
100 K+
Nøyaktighet SLA
0 %+
Språkstøttet
10 +
Intern global arbeidsstyrke
1000 +
🔒 HIPAA-kompatibel
🇪🇺 GDPR-klar
✅️ ISO 27001-sertifisert
✅️ SOC 2 Type II-klar

Hva er NER

Analyser data for å oppdage meningsfull innsikt

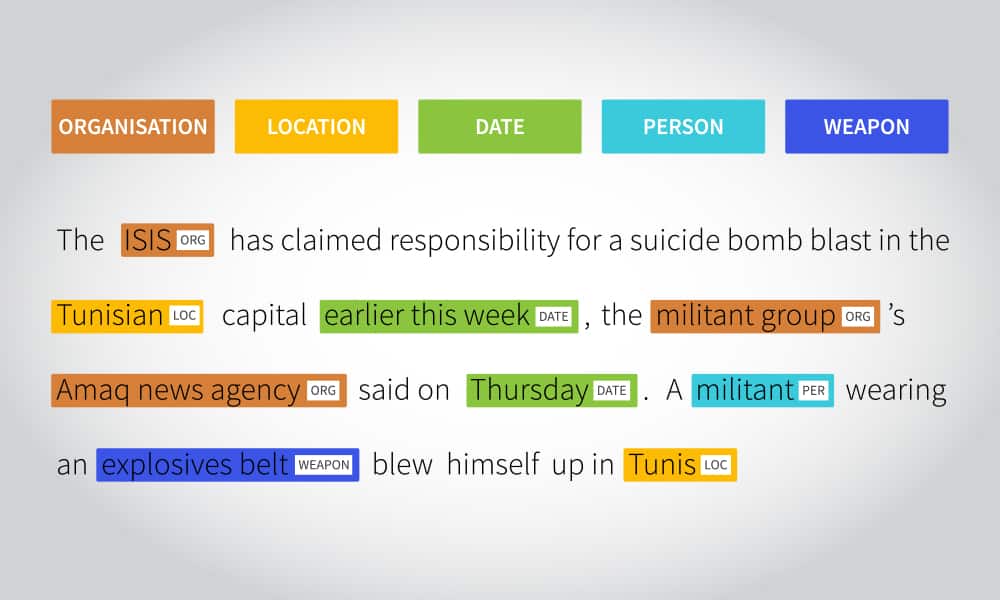
Navngitt Entity Recognition (NER), identifiserer og klassifiserer enheter som mennesker, organisasjoner og steder i ustrukturert tekst. NER forbedrer datautvinning, forenkler informasjonsinnhenting og driver avanserte AI-applikasjoner, noe som gjør det til et viktig verktøy for bedrifter å utnytte. Med NER kan organisasjoner få verdifull innsikt, forbedre kundeopplevelser og effektivisere prosesser.

Shaip NER er utviklet for å la organisasjoner låse opp kritisk informasjon i ustrukturerte data og lar deg oppdage relasjoner mellom enheter fra regnskaper, forsikringsdokumenter, anmeldelser, legenotater osv. NER kan også bidra til å identifisere relasjoner mellom enheter av samme type, for eksempel flere organisasjoner eller individer nevnt i et dokument, noe som er viktig for konsistens i enhetstagging og forbedring av modellnøyaktigheten. Med rik erfaring innen NLP og lingvistikk er vi godt rustet til å levere domenespesifikk innsikt for å håndtere annoteringsprosjekter av alle størrelser.

Navngitt enhetsgjenkjenning (ner)

Hvorfor team outsourcer NER til Shaip

NER-annotering uten risiko

Det er vanskelig å gjøre rå, rotete tekst om til opplæringsklare NER-data når du ikke har et eget annoteringsteam. Vi håndterer det fra ende til annen – nøyaktig, sikkert og i den skalaen modellene dine trenger.

Å gjøre det alene er risikabelt

  • Ikke noe internt annotasjonsteam – og ingen tid til å bygge et.
  • Inkonsekvente etiketter og rotete avgjørelser i kantsaker.
  • Sensitive data eksponert for ukontrollerte, ad hoc-leverandører.
  • Retningslinjer som stadig endrer seg etter hvert som modellen din utvikler seg.

Med Shaip håndteres det

  • Et trent NER-annotasjonsteam, klart til oppstart om få dager.
  • Tydelige retningslinjer og kvalitetssikring i flere omganger for konsistente og nøyaktige etiketter.
  • Sikkerhet i bedriftsklassen – taushetsplikt som standard, HIPAA- og SOC 2-samsvar.
  • En velprøvd prosess bygget for å skaleres og tilpasses endrede spesifikasjoner.

Hva vi gjør

NER-annotasjonstjenester

Fullservice annotering av navngitte enheter – fra generelle enheter til de mest spesialiserte, regulerte domenene.

1

Navngitt entitetsgjenkjenning (NER)

Navngitt enhetsgjenkjenning i maskinlæring er en del av naturlig språkbehandling. Hovedmålet med NER er å behandle strukturerte og ustrukturerte data og klassifisere disse navngitte enhetene i forhåndsdefinerte kategorier. Noen vanlige kategorier inkluderer navn, personenhet, sted, selskap, tid, pengeverdier, hendelser og mer.

  • Bruk case nlp: navngitt enhetsgjenkjenningsner Se på video 1.1

    Generelt domene

    Identifisering av personer, steder, organisasjoner, datoer og andre vanlige enheter i generell tekst som nyheter, nettinnhold, e-poster og kundesamtaler, merket konsekvent for å trene NER-modeller for bred språkforståelse.

  • Forsikringsdomene
    1.2

    Forsikringsdomene

    Uttrekk av nøkkelenheter fra forsikringsdokumenter, inkludert forsikringssummer, erstatningsgrenser og polisegrenser, estimater som lønnsslipp, omsetning og gebyrinntekter, kjøretøyplaner og poliseforlengelser med indre grenser.

  • Medisinsk videominiatyrbilde Se på video 1.3

    Klinisk domene

    Identifisering av problemer, anatomiske strukturer, medisiner og prosedyrer i ustrukturerte pasientjournaler som elektroniske helsejournaler og legenotater, kommentert av helseeksperter for å gjøre kompleks klinisk tekst om til strukturerte, brukbare data.

Nøkkelsetningskommentar
2

Nøkkelfrase-annotasjon (KP)

Den identifiserer en diskret substantivfrase i en tekst. En substantivfrase kan enten være enkel (f.eks. enkelthodeord som substantiv, egennavn eller pronomen) eller kompleks (f.eks. en substantivfrase som har et hodeord sammen med tilhørende modifikatorer)

Pii-kommentar
3

PII-kommentar

PII refererer til personlig identifiserbar informasjon. Denne oppgaven innebærer merknader av eventuelle nøkkelidentifikatorer som kan relateres tilbake til en persons identitet.

Phi-kommentar
4

PHI-anmerkning

PHI viser til Beskyttet helseinformasjon. Denne oppgaven innebærer merknader av 18 sentrale pasientidentifikatorer som identifisert under HIPAA, for å avidentifisere en pasientjournal/identitet.

5

Hendelsesanmerkning

Identifikasjon av informasjon som hvem, hva, når, hvor om en hendelse, f.eks. angrep, kidnapping, investering osv. Denne merknadsprosessen har følgende trinn:

  1. Entitetsidentifikasjon
    Trinn 5.1

    Enhetsidentifikasjon (f.eks. person, sted, organisasjon osv.)

  2. Identifikasjon av ord som angir hovedhendelsen
    Trinn 5.2

    Identifisering av ord som betegner hovedhendelsen (dvs. utløserord)

  3. Identifikasjon av forholdet mellom en trigger og entitet
    Trinn 5.3

    Identifisering av forholdet mellom en trigger og entitetstyper

Dybde og kompleksitet

Fra standardtagger til gullstandarddatasett

Uansett hva entitetsskjemaet ditt krever, håndterer våre annotatorer det – inkludert de vanskelige tilfellene de fleste leverandører unngår.

standard

Standard enhetstagging

Kjerneenhetstyper merket med skjemaet ditt.

Custom

Enheter for tilpassede domener

Skreddersydde enhetstyper for din bransje og bruksområde.

Finkornet

Finkornet klassifisering

Undertyper og hierarkier, ikke bare brede bøtter.

Complex

Nestede og overlappende enheter

Enheter innenfor enheter, håndtert nøyaktig.

Flermerkelapp

Tildeling av flere etiketter

Flere gyldige etiketter per spenn der konteksten krever det.

attributter

Attributt- og metadatamerking

Berik enheter med attributter og relasjoner.

normalisering

Enhetsnormalisering

Tilordne varianter til én kanonisk enhet.

datasett

Gullstandarddatasett

Vurderte, revisjonsklare referansedata.

Bygget for moderne AI

NER-data for LLM-er, RAG og finjustering

Navngitt enhetsgjenkjenning (ner)

Enhetsmerkede data gjør mer enn å drive klassiske NLP-pipelines. De begrunner gjenfinning, strukturerer kunnskap for RAG og skjerper finjusterte modeller på enhetene som er viktige for virksomheten din.

Vi bygger datasettene som gjør at modellene dine trekker ut de riktige enhetene – pålitelig, i ditt domene, i produksjonsskala.

LLM-treningsdata RAG-jording Finjustering av datasett Kunnskapsgrafer Entitetskobling

Bransjer vi betjener

NER-brukstilfeller etter bransje

🏥

Helse og farma

Hent ut sykdommer, legemidler og prosedyrer fra kliniske notater og forskning for å drive medisinsk AI.

💳

Finans og bank

Hent selskaper, beløp og instrumenter fra innleveringer og regnskaper for risiko og samsvar.

🇧🇷

Lovlig

Identifiser parter, klausuler og forpliktelser på tvers av kontrakter og saksmapper.

💬

Kundeservice

Rute og klassifisere saker ved å trekke ut produkter, problemer og intensjoner fra meldinger.

🛒

E-handel og detaljhandel

Tagg merker, produkter og attributter for å forbedre søk, anbefalinger og kataloger.

📰

Media og offentlig sektor

Spor personer, organisasjoner og steder for overvåking, forskning og dokumentasjonsarbeidsflyter.

Hvorfor kjøpere velger Shaip for NER

Skala, ekspertise og nøyaktighet du kan stole på

Datainnsamlingsmuligheter

Lag, kurater og saml spesialbygde datasett (tekst, tale, bilde, video) fra hele verden basert på tilpassede retningslinjer.

Fleksibel global arbeidsstyrke

Dra nytte av over 10 000 interne globale arbeidsstyrker og over 500 000 autoriserte bidragsytere i crowdscale. Oversikt over arbeidsstyrkens kapasitet og effektivitet i sanntid.

Kvalitet

Vår proprietære plattform og dyktige arbeidsstyrke bruker flere kvalitetskontrollmetoder for å møte eller overgå kvalitetsstandarder.

Variert, nøyaktig og rask

Prosessen vår effektiviserer innsamlingsprosessen gjennom enklere oppgavefordeling og datafangst direkte fra appen og nettet.

Data Security

Oppretthold fullstendig datakonfidensialitet ved å gjøre personvernet til vår prioritet. Vi sikrer at dataformater er policykontrollert og bevart.

Ende-til-ende-annotering

Hvert innsamlet datasett kan annoteres, merkes, transkriberes og valideres i samme arbeidsflyt, noe som leverer modellklare treningsdata.

Hvordan fungerer det

Vår NER-annoteringsprosess

En tydelig, kontrollert arbeidsflyt fra brief til levering – med innebygd kvalitet i hvert trinn.

1. Forstå og omfang

Vi tilpasser oss enhetsskjemaet, kanttilfellene og domenekravene dine, og setter deretter retningslinjer for annotering.

2. Kommenter med eksperter

Domeneopplærte annotatorer merker dataene dine, veiledet av teamledere for å holde beslutningene konsistente.

3. Kvalitetssikring og levering i flere omganger

Flertrinns gjennomgang, vurdering og kontroller av enighet mellom kommentatorer før opplæringsklar levering.

Dokumenterte resultater for ekte AI-team

Hvordan Shaip omdanner komplekse, sensitive data til opplæringsklare datasett – sikkert og i stor skala.

Over 50 000 søk klassifisert for bedre søkerelevans
Shaip klassifiserte over 50 000 ekte e-handelssøk for å redusere tvetydighet og skjerpe søkeresultatene for en stor nettforhandler.
Forbedring av søket

Problem: Millioner av daglige søk – fulle av skrivefeil, tvetydigheter og overlappende kategorier – skadet søkerelevansen og kundeopplevelsen.

Løsning: Et annoteringsrammeverk med 11 klasser med klare prioritetsregler og en arbeidsflyt i 3 trinn: annotering, kvalitetssikringsgjennomgang og SME-voldgift for kantsaker.

Resultat: Over 50 000 søk klassifisert med høy presisjon – forbedret relevans, produktoppdagbarhet og brukertilfredshet.

10 000 sider med onkologiske data for NLP-opplæring
Shaip leverte avidentifiserte, ekspertkommenterte onkologijournaler for å hjelpe en helseklient med å trene opp NLP-modeller for kreftforskning.
Onkologisk datapresisjon

Problem: En leder innen helsevesenet måtte utvinne store mengder onkologiske journaler for NLP – uten å gå på akkord med pasientenes personvern eller klinisk nøyaktighet.

Løsning: Samlede data fra over 5 millioner helsejournaler, HIPAA Safe Harbor-avidentifikasjon og onkologiutdannede annotatorer som merker kliniske enheter, relasjoner og negasjon.

Resultat: Over 10 000 høykvalitets, avidentifiserte og merkede poster – et sikkert og opplæringsklart datasett for klientens NLP-modellutvikling.

Sikkerhet og samsvar

GDPR
HIPAA
ISO 9001: 2015
SOC 2 Type II
ISO 27001
Shaip kontakt oss

Vil du bygge dine egne NER-treningsdata?

Kontakt oss nå for å lære hvordan vi kan samle inn et tilpasset NER-datasett for din unike AI/ML-løsning

  • Dette feltet er for validering formål og bør stå uendret.
  • Ved å registrere meg godtar jeg Shaip Personvernerklæring og Våre vilkår og gi mitt samtykke til å motta B2B-markedsføringskommunikasjon fra Shaip.

NER-annoteringstjenester tilbyr ekspertmerkede treningsdata for gjenkjenning av navngitte enheter – et team tagger enheter som personer, organisasjoner, steder, datoer og domenespesifikke termer i teksten din, slik at NLP- eller LLM-modellen din kan lære å trekke dem ut nøyaktig. Shaip tilbyr dette fra ende til ende, inkludert retningslinjer, annotering og kvalitetskontroll i flere omganger.

Spesialister på AI-data som Shaip bygger tilpassede NER-datasett. Shaip leverer flerspråklige, domenespesifikke enhetsdata – inkludert kliniske, økonomiske og PII/PHI – med bedriftssikkerhet og kontinuerlig QA, klar for NLP, LLM, RAG og finjustering av arbeidsmengder.

Kostnaden avhenger av datavolum, antall og kompleksitet av enhetstyper, språk, nødvendig domeneekspertise og kvalitets- og leveringstidsmål. Shaip tilpasser hvert prosjekt til dine behov og kan starte med en gratis pilot slik at du ser kvalitet og pris før du forplikter deg.

Ja. Shaip annoterer enheter konsekvent på tvers av over 60 språk og skript ved hjelp av annotatorer for morsmålstalende og språkspesifikk kvalitetssikring.

Ja. Shaip tilbyr klinisk og medisinsk NER, og PII/PHI-annotering som dekker alle 18 HIPAA-identifikatorer, håndtert av domeneopplærte annotatorer under HIPAA-tilpassede, sikre arbeidsflyter.

Tydelige retningslinjer for annotering, domeneopplærte annotatorer, teamledet tilsyn og flertrinns kvalitetssikring med vurdering og avtalesjekker mellom annotatorer før levering.

Sikkerhet er standard: taushetsplikt som standard, tilgangskontroller og prosesser i samsvar med HIPAA, SOC 2, ISO 27001, GDPR og CCPA. Dataene dine forblir beskyttet gjennom hele oppdraget.

De fleste prosjekter kan starte i løpet av få dager. En gratis pilotløsning lar deg validere kvaliteten raskt, hvoretter Shaip skalerer til ditt fulle volum innenfor en avtalt tidsramme.