Kunstig intelligens (KI) endrer måten vi løser problemer på i alle bransjer, fra helsevesen til bankvirksomhet. Imidlertid gjenstår én stor utfordring: skjevhet i KI-systemer . Dette skjer når dataene som brukes til å trene KI ikke er mangfoldige nok. Uten et bredt utvalg av data kan KI ta urettferdige beslutninger, ekskludere visse grupper eller gi unøyaktige resultater.
For å gjøre AI smartere, mer rettferdig og mer effektivt, må vi fokusere på mangfoldige treningsdata . I denne bloggen skal vi forklare hvorfor datamangfold er viktig, hvordan det bidrar til å eliminere skjevheter, og hvilke steg du kan ta for å lage bedre AI-systemer.
Hvorfor er mangfold i treningsdata viktig?
Det er treningsdata som lærer AI-modeller hvordan de skal fungere. Hvis dataene er begrensede eller ensidige, vil AI-en bare lære fra det snevre perspektivet. Dette kan føre til problemer som partiske beslutninger eller dårlig ytelse i virkelige situasjoner. Her er hvorfor mangfoldige data er så viktige:
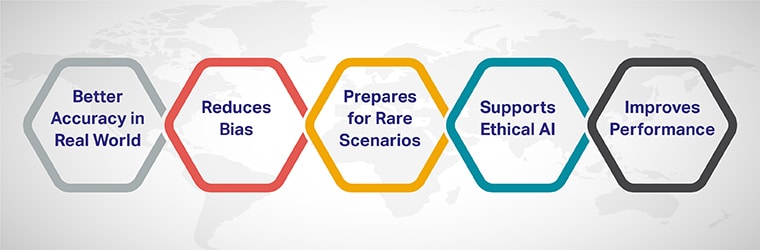
1. Bedre nøyaktighet i den virkelige verden
AI-modeller som er trent på en rekke data kan håndtere ulike situasjoner bedre. For eksempel vil en stemmeassistent som er trent på stemmer i alle aldre, aksenter og kjønn fungere for flere mennesker sammenlignet med en som er trent på bare noen få stemmer.
2. Reduserer skjevhet
Uten mangfold kan AI fange opp og forsterke skjevheter i dataene. Hvis for eksempel en ansettelsesalgoritme kun trenes på CV-er fra menn, kan den urettferdig favorisere dem fremfor like kvalifiserte kvinner. Å inkludere data fra alle grupper sikrer mer rettferdige resultater.
3. Forbereder seg på sjeldne scenarier
Ulike datasett inkluderer sjeldne eller unike tilfeller som AI kan støte på. For eksempel må selvkjørende biler trenes på alle slags veiforhold, inkludert uvanlige som oversvømmede gater eller hull i veien.
4. Støtter etisk AI
AI brukes innen områder som helsevesen og strafferett, der rettferdighet og etikk er avgjørende. Mangfoldige opplæringsdata sikrer at AI tar beslutninger som er rettferdige for alle, uavhengig av bakgrunn.
5. Forbedrer ytelsen
Når AI lærer fra ulike data, blir den bedre til å gjenkjenne mønstre og komme med nøyaktige forutsigelser. Dette fører til smartere og mer pålitelige systemer.
Det nåværende problemet med treningsdata
Akkurat nå feiler mange AI-systemer fordi treningsdataene deres ikke er mangfoldige nok. Eksempler inkluderer ansiktsgjenkjenningssystemer som ikke gjenkjenner mørkere hudtoner eller chatboter som gir støtende svar. Disse feilene viser hvorfor vi må fokusere på å inkludere mer mangfoldige data i løpet av AI-treningsprosessen.
Hvordan gjøre treningsdata mer mangfoldige
Det krever innsats å lage mangfoldige treningsdata, men det er mulig med de riktige strategiene. Slik kan du sørge for at dataene dine er inkluderende og balanserte:
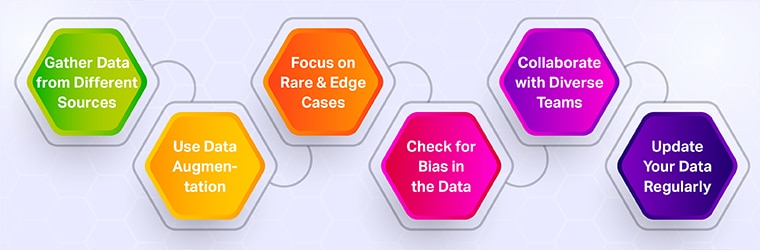
1. Samle inn data fra forskjellige kilder
Ikke stol på bare én datakilde. Samle inn informasjon fra forskjellige regioner, aldersgrupper, kjønn og etnisiteter. Hvis du for eksempel bygger en språkmodell, inkluder tekst fra forskjellige kulturer og språk.
2. Bruk datautvidelse
Datautvidelse er en metode for å lage nye data fra eksisterende data. Du kan for eksempel vende, rotere eller justere bilder for å skape mer variasjon uten å samle inn ytterligere data.
3. Fokuser på sjeldne tilfeller og ekstreme tilfeller
Inkluder eksempler på sjeldne situasjoner i treningsdataene dine. Hvis du for eksempel trener en AI innen helsevesenet, inkluder data fra pasienter med sjeldne tilstander for å gjøre modellen mer omfattende.
4. Sjekk for skjevhet i dataene
Før du bruker et datasett, bør du gjennomgå det for å sikre at det ikke favoriserer eller ekskluderer noen grupper. Hvis du for eksempel trener opp programvare for ansiktsgjenkjenning, må du sørge for at datasettet inkluderer ansikter i alle hudtoner og kjønn.
5. Samarbeid med ulike team
Jobb med folk fra ulik bakgrunn for å identifisere hull i dataene dine. Et mangfoldig team kan bidra med unike perspektiver og sikre rettferdighet i AI-utvikling.
6. Oppdater dataene dine regelmessig
Verden endrer seg over tid, og det bør også dataene dine. Oppdater treningsdataene dine regelmessig for å gjenspeile nye trender, teknologier og samfunnsendringer.
[ Les også: Hva er treningsdata i maskinlæring ]
Utfordringer med å sikre datamangfold
Selv om mangfoldige treningsdata er viktig, er det ikke alltid lett å oppnå. Her er noen vanlige utfordringer:
- Høye kostnader: Det kan være dyrt og tidkrevende å samle inn og merke ulike data.
- Juridiske begrensninger: Ulike land har lover om hvordan data kan samles inn og brukes, som GDPR i Europa.
- Datagap: I noen tilfeller er det vanskelig å finne data for underrepresenterte grupper eller sjeldne scenarier.
For å overvinne disse utfordringene trenger du en gjennomtenkt plan og samarbeid med eksperter.
Bygge etisk og inkluderende AI
I kjernen av KI bør det hjelpe alle, ikke bare noen få utvalgte. Ved å fokusere på mangfoldige treningsdata kan vi lage systemer som er smartere, mer rettferdige og mer inkluderende. Dette er ikke bare et teknisk mål. Det er et ansvar å sørge for at KI gagner samfunnet som helhet.
Hvordan Shaip kan hjelpe
Hos Shaip spesialiserer vi oss på å tilby datasett av høy kvalitet, skreddersydd til dine spesifikke AI-behov. Enten du bygger en helseapp, en chatbot eller et ansiktsgjenkjenningssystem, kan vi hjelpe deg med å lage inkluderende og pålitelige AI-løsninger.
La oss bygge smartere AI sammen!
Kontakt oss i dag for å diskutere dine behov for opplæringsdata. Sammen kan vi gjøre AI mer rettferdig, smartere og mer effektiv.