Datasett for helseopplæring kommer fra fire kilder: offentlige forskningskorpus, lisensierte kommersielle datasett, tilpasset samling og syntetisk generering. For de fleste prosjekter er begrensningen ikke om et datasett eksisterer, men om lisensen tillater kommersiell modellopplæring og omdistribusjon av modeller som er trent på det.
I dagens verden drives helsevesenet i økende grad av maskinlæring (ML). ML forvandler helseutfall, fra å forutsi sykdommer til å forbedre diagnostikk. Imidlertid begynner hvert ML-prosjekt med én hjørnestein: kvalitetsdatasett for helsevesenet for maskinlæring.
I denne bloggen har vi samlet gratis og åpne medisinske datasett og helsedatasett for maskinlæring på tvers av kategorier som generell helsevesen, medisinsk avbildning, genomikk og sykehus. Enten du er forsker eller utvikler, vil disse datasettene hjelpe deg med å bygge robuste og innovative helsemodeller.
Hva er helsedatasett?
Et helse- eller medisinsk datasett er en samling av helserelatert informasjon, som pasientjournaler, laboratorieresultater, medisinske bilder eller behandlingshistorikk. Disse samlingene – ofte kalt helsedatasett eller medisinske datasett – er organisert i datalagre designet for forskning, folkehelse og klinisk bruk.
Disse datasettene brukes til å studere sykdommer, forbedre behandlinger og utvikle verktøy som AI-modeller for bedre diagnose og behandling. Mange helsedatasett inneholder avidentifiserte helserelaterte data, noe som sikrer at pasientenes personvern beskyttes samtidig som det muliggjør verdifull forskning og analyse.
De spiller en nøkkelrolle i å fremme forskning og forbedre pasientutfall.
Viktigheten av helsedatasett for opplæring av maskinlæringsmodellen din
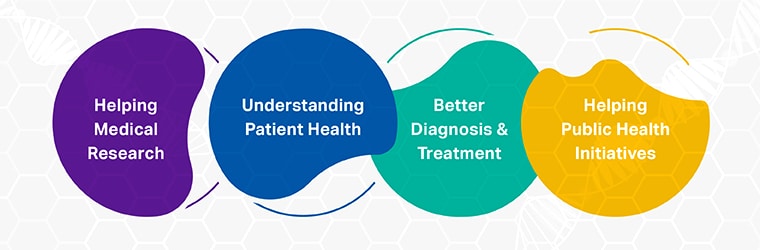
Helsedatasett er samlinger av pasientinformasjon, som medisinske journaler, diagnoser, behandlinger, genetiske data og livsstilsdetaljer. Datavitenskap spiller en avgjørende rolle i å analysere disse helsedatasettene, slik at forskere kan avdekke innsikt og drive innovasjon i pasientbehandling. De er svært viktige i dagens verden, der kunstig intelligens brukes mer og mer. Her er hvorfor: Referansedatasett er viktige for å evaluere og sammenligne ytelsen til maskinlæringsmodeller i helsevesenet, spesielt når man vurderer helsedatasett for maskinlæring på tvers av institusjoner.
[Les også: Hvorfor helsedatasett er viktige for å forme fremtiden for medisinsk AI ]
Forstå pasientens helse:
Medical Note datasett gir leger et fullstendig bilde av en pasients helse. For eksempel kan data om en pasients sykehistorie, medisiner og livsstil bidra til å forutsi om de kan få en kronisk sykdom. Dette lar legene gå tidlig inn og lage en behandlingsplan kun for den pasienten.
Hjelper medisinsk forskning:
Ved å studere datasett fra helsevesenet kan medisinske forskere se på hvordan kreftpasienter blir behandlet og hvordan de blir friske. De kan finne behandlingene som fungerer best i den virkelige verden. Ved å se på tumorprøver i biobanker analyserer for eksempel ofte genuttrykk og bruker datasett relatert til spesifikke tumortyper og genprofiler for å forstå kreftprogresjon, samt hvordan spesifikke mutasjoner og kreftproteiner reagerer på ulike behandlinger. Denne datadrevne tilnærmingen bidrar til å finne trender som fører til bedre pasientresultater.
Bedre diagnose og behandling:
AI-drevne verktøy bruker medisinske diagnosedatasett, som kan inkludere vitale tegn som hjertefrekvens og blodtrykk, for å avdekke mønstre som hjelper leger med å diagnostisere og behandle sykdommer mer effektivt. Innen radiologi kan AI raskt identifisere avvik i skanninger med imponerende nøyaktighet, noe som muliggjør tidligere sykdomsdeteksjon. Etter hvert som disse datasettene fortsetter å utvikle seg, forbedrer innovasjoner som medisinsk bildeannotering diagnostiske prosesser ytterligere, og å inkludere pasientdemografi i disse datasettene bidrar til å skreddersy diagnostiske verktøy til ulike populasjoner, noe som fører til bedre helseresultater for pasienter.
Hjelpe folkehelseinitiativer:
Tenk deg en liten by der helseeksperter brukte datasett til å spore et influensautbrudd. De så på mønstre og fant områdene som var berørt. Med disse dataene startet de målrettede vaksinasjonskampanjer og helseopplæringskampanjer. Denne datadrevne tilnærmingen bidro til å begrense influensaen. Datasett som disse er også viktige for sykdomskontroll og for å overvåke trender innen barneernæring i folkehelsen. Det viser hvordan helsedatasett aktivt kan veilede og forbedre folkehelseinitiativer, der sporing av barneernæring er en kritisk komponent i mange folkehelsedatasett.
Kilder til kliniske data
Kliniske data danner ryggraden i moderne helsedatasett, og tilbyr en omfattende samling av informasjon som driver fremskritt innen pasientbehandling og medisinsk forskning. Disse dataene hentes fra en rekke kanaler, inkludert elektroniske helsejournaler (EHR-er), medisinsk avbildning og genomsekvensering. Verdens helseorganisasjon (WHO) kuraterer et globalt helsedatalager som gir tilgang til kliniske data fra helsesystemer over hele verden. Denne rikdommen av helsedata gjør det mulig for forskere å utføre helseanalyser og avdekke verdifull innsikt i sykdomsmønstre, behandlingseffektivitet og pasientutfall.
Spesialiserte datasett, som Alzheimer's Disease Neuroimaging Initiative (ADNI) og The Cancer Genome Atlas (TCGA), beriker landskapet ytterligere ved å tilby detaljerte kliniske data om sykdomsprogresjon, genetiske markører og terapeutiske responser. Disse ressursene er avgjørende for å utvikle maskinlæringsmodeller som kan forutsi kliniske utfall, tilpasse behandlinger og til slutt forbedre pasientutfall samtidig som de reduserer helsekostnadene. Ved å utnytte en så omfattende samling av kliniske data er helsevesenet bedre rustet til å håndtere globale helseutfordringer og drive innovasjon innen medisinsk forskning.
[Les også: Rollen til multimodale medisinske datasett i å fremme AI-forskning ]
Utforsk 22 åpne og gratis datasett for medisinsk og biovitenskapelig læring
Åpne datasett for helsevesenet er avgjørende for at enhver maskinlæringsmodell skal fungere bra. Mange åpne datasett er hentet fra store helsedatabaser som vedlikeholdes av nasjonale institutter og sosiale tjenesteorganisasjoner. Maskinlæring brukes allerede innen biovitenskap, helsevesen og medisin, og det viser gode resultater. Det bidrar til å forutsi sykdommer og forstå hvordan de sprer seg. Maskinlæring gir også ideer om hvordan vi kan ta vare på syke, eldre og uvelkomne mennesker i et lokalsamfunn på en god måte. Uten gode datasett ville ikke disse maskinlæringsmodellene være mulige. For praktikere kan det å kuratere helsedatasett for maskinlæring effektivisere eksperimentering og benchmarking betydelig.
Generell og folkehelse:
- data.gov: Fokuserer på USA-orienterte helsetjenester som enkelt kan søkes ved hjelp av flere parametere. Datasettene er utformet for å forbedre trivselen til individer bosatt i USA; Imidlertid kan informasjonen også være nyttig for andre opplæringssett innen forskning eller andre folkehelsedomener.
- HVEM: Tilbyr datasett sentrert rundt globale helseprioriteringer. Plattformen har en brukervennlig søkefunksjon og gir verdifull innsikt ved siden av datasettene for en helhetlig forståelse av emnene.
- Re3Data: Tilbyr data som spenner over mer enn 2,000 forskningsemner kategorisert i flere brede områder. Selv om ikke alle datasett er fritt tilgjengelig, indikerer plattformen tydelig strukturen og muliggjør enkelt søk basert på faktorer som avgifter, medlemskrav og opphavsrettsbegrensninger.
- Database for menneskelig dødelighet tilbyr tilgang til data om dødelighet, befolkningstall og ulike helse- og demografistatistikker for 35 nasjoner.
- CHDS: Datasettene fra Child Health and Development Studies tar sikte på å undersøke overføring av sykdom og helse mellom generasjoner. Den omfatter datasett for å undersøke ikke bare genomisk uttrykk, men også påvirkningen av sosiale, miljømessige og kulturelle faktorer på sykdom og helse.
- Merck Molecular Activity Challenge: Presenterer datasett designet for å fremme bruken av maskinlæring i legemiddeloppdagelse ved å simulere potensielle interaksjoner mellom ulike molekylkombinasjoner.
- 1000 genomer Prosjekt: Inneholder sekvenseringsdata fra 2,500 individer over 26 forskjellige populasjoner, noe som gjør det til et av de største tilgjengelige genomlagrene. Dette internasjonale samarbeidet kan nås gjennom AWS. (Merk at tilskudd er tilgjengelig for genomprosjekter.)
Medisinske bildedatasett for biovitenskap, helsevesen og medisin:
- Åpne Neuro: Som en gratis og åpen plattform deler OpenNeuro et bredt spekter av medisinske bilder, inkludert MR-, MEG-, EEG-, iEEG-, ECoG-, ASL- og PET-data. Med 563 medisinske datasett som dekker 19,187 XNUMX deltakere, fungerer det som en uvurderlig ressurs for forskere og helsepersonell.
- Oasis: Dette datasettet stammer fra Open Access Series of Imaging Studies (OASIS), og forsøker å gi nevroavbildningsdata til publikum gratis til fordel for det vitenskapelige samfunnet. Den omfatter 1,098 2,168 forsøkspersoner fordelt på 1,608 XNUMX MR-sesjoner og XNUMX XNUMX PET-økter, og tilbyr et vell av informasjon for forskere.
- Alzheimers sykdom Neuroimaging Initiative: Alzheimer's Disease Neuroimaging Initiative (ADNI) viser frem data samlet inn av forskere over hele verden som er dedikert til å definere utviklingen av Alzheimers sykdom. Datasettet inkluderer en omfattende samling av MR- og PET-bilder, genetisk informasjon, kognitive tester og CSF og blodbiomarkører, noe som letter en mangefasettert tilnærming til å forstå denne komplekse tilstanden.
- MIMIC-IIIEn omfattende database med data om intensivpasienter, inkludert bildediagnostiske rapporter og klinisk informasjon, er tilgjengelig gjennom MIMIC-III. Denne anonymiserte ressursen støtter forskning på intensivbehandling og prediktiv modellering.
- CheXpertFor automatisert tolkning av røntgenbilder av brystkassen tilbyr CheXpert et stort datasett med over 224,000 XNUMX røntgenbilder av brystkassen med usikkerhetsmerkinger. Dette spiller en avgjørende rolle i radiologiforskning og sykdomsdeteksjon.
- HAM10000HAM10000 fremmer dermatologisk forskning og forutsigelse av hudkreft, og tilbyr 10,000 XNUMX dermatoskopiske bilder for å oppdage pigmenterte hudlesjoner.
Sykehusdatasett:
- Leverandørdatakatalog: Få tilgang til og last ned omfattende leverandørdatasett innen områder inkludert dialysefasiliteter, legepraksis, hjemmehelsetjenester, hospice, sykehus, rehabilitering på sykehus, langtidspleiesykehus, sykehjem med rehabiliteringstjenester, legekontorbesøkskostnader og leverandørkataloger.
- Healthcare Cost and Utilization Project (HCUP): Denne omfattende, landsomfattende databasen ble opprettet for å identifisere, spore og analysere nasjonale trender innen bruk av helsetjenester, tilgang, gebyrer, kvalitet og resultater. Hvert medisinsk datasett i HCUP inneholder informasjon på møtenivå om alle pasientopphold, akuttmottaksbesøk og ambulerende operasjoner i amerikanske sykehus, og gir et vell av data for forskere og beslutningstakere.
- MIMIC Critical Care Database: Dette åpent tilgjengelige medisinske datasettet er utviklet av MIT for Computational Physiology, og omfatter avidentifiserte helsedata fra over 40,000 XNUMX kritiske pasienter. MIMIC-datasettet fungerer som en verdifull ressurs for forskere som studerer kritisk omsorg og utvikler nye beregningsmetoder.
Kreftdatasett:
- CT medisinske bilder: Designet for å lette alternative metoder for å undersøke trender i CT-bildedata, inneholder dette datasettet CT-skanninger av kreftpasienter, med fokus på faktorer som kontrast, modalitet og pasientalder. Forskere kan utnytte disse dataene til å utvikle nye bildeteknikker og analysere mønstre i kreftdiagnose og behandling.
- Internasjonalt samarbeid om kreftrapportering (ICCR)De medisinske datasettene i ICCR er utviklet og levert for å fremme en evidensbasert tilnærming til kreftrapportering over hele verden. Ved å standardisere kreftrapportering har ICCR som mål å forbedre kvaliteten og sammenlignbarheten av kreftdata på tvers av institusjoner og land.
- SEER kreftforekomst: Levert av den amerikanske regjeringen, er disse kreftdataene segmentert ved hjelp av grunnleggende demografiske distinksjoner som rase, kjønn og alder. SEER-datasettet lar forskere undersøke kreftforekomst og overlevelsesrater på tvers av ulike befolkningsundergrupper, informere folkehelseinitiativer og forskningsprioriteringer.
- Datasett for lungekreft: Dette gratis datasettet inneholder informasjon om lungekrefttilfeller som dateres tilbake til 1995. Forskere kan bruke disse dataene til å studere langsiktige trender i lungekreftforekomst, behandling og utfall, samt å utvikle nye diagnostiske og prognostiske verktøy.
Ytterligere ressurser for helsedata:
- kaggle: Et allsidig datasettlager – Kaggle er fortsatt en fremragende plattform for et bredt utvalg av datasett, ikke begrenset til helsesektoren. Ideell for de som forgrener seg til ulike fag eller som trenger forskjellige datasett for modelltrening, er Kaggle en god ressurs.
- subreddit: Et fellesskapsdrevet skattekammer – De riktige subreddit-diskusjonene kan være en gullgruve for åpne datasett. For nisje- eller spesifikke forespørsler som ikke adresseres av offentlige datasett, kan Reddit-fellesskapet ha svaret.
Fordeler og ulemper med åpne dataplattformer
Åpne dataplattformer gir uvurderlige ressurser for forskere, og fremmer innovasjon, samarbeid og kostnadseffektiv tilgang til helsedata. Utfordringer som datakvalitetsproblemer, personvernhensyn og tekniske barrierer kan imidlertid begrense effektiviteten deres. Å balansere disse fordelene og ulempene er avgjørende for å maksimere potensialet deres for å drive fremskritt innen helseforskning.
| Pros | Ulemper |
|---|---|
| tilgjengelighetFritt tilgjengelige datasett gjør det enklere for forskere og dataforskere å få tilgang til verdifull informasjon. | Problemer med datakvalitetDatasett med åpen tilgang kan mangle standardisering eller inneholde ufullstendige eller utdaterte data. |
| SamarbeidetOppmuntrer til tverrfaglig og bransjeovergripende samarbeid innen forskning og innovasjon. | Personvern BekymringerSelv anonymiserte datasett kan utgjøre en risiko for reidentifisering av sensitiv informasjon. |
| Innovasjon:Driver utviklingen av maskinlæringsmodeller og verktøy for helseanalyse og forskning. | Begrenset omfangEnkelte datasett representerer kanskje ikke ulike populasjoner eller dekker alle nødvendige helseområder. |
| KostnadseffektivMuliggjør kostnadsbesparelser ved å tilby gratis ressurser, og eliminerer behovet for dyre, proprietære data. | Overforbruk av syntetiske dataStor avhengighet av syntetiske data kan føre til unøyaktigheter eller skjevheter i modeller. |
| KunnskapsdelingFremmer åpenhet og akselererer formidlingen av forskningsfunn. | Tekniske barriererTilgang til og analyse av store datasett kan kreve avanserte tekniske ferdigheter og ressurser. |
Hvordan velge mellom offentlig, lisensiert, tilpasset og syntetisk
Offentlige korpora er gratis, godt dokumenterte og sterkt overforesydde, noe som gjør dem utmerkede for grunnlinjer og dårlige for differensiering; lisensene deres forbyr ofte kommersiell bruk. Lisensierte kommersielle datasett gir skala og hastighet på et klart kontraktsmessig grunnlag, med den avveiningen at konkurrenter har de samme dataene. Tilpasset innsamling gir differensiering og nøyaktig tilpasning på bekostning av tid og budsjett. Syntetiske data adresserer PHI og sjeldne hendelsesproblemer, men må først valideres mot reelle data. De fleste produksjonsprogrammer kombinerer alle fire.
Lisensspørsmål som må avklares før dataene lander
Tillater lisensen trening av kommersiell modell? Tillater den omdistribusjon av en modell som er trent på dataene? Tillater den avledede datasett? Hva skjer ved avslutning, og må modeller trenes på nytt? Er det en begrensning i bruksfeltet? Finnes det attribusjonskrav som overlever i produktet.
Datakvalitet og -sikkerhet i medisinske datasett
Det er avgjørende å opprettholde høye standarder for datakvalitet og sikkerhet når man jobber med medisinske datasett. Å sikre datakvalitet innebærer strenge validerings- og rengjøringsprosesser for å eliminere feil og inkonsekvenser, noe som er avgjørende for å produsere pålitelige forskningsresultater. På sikkerhetsfronten er robuste tiltak som kryptering, tilgangskontroller og sikker lagring avgjørende for å beskytte sensitiv helseinformasjon.
Avidentifisering av datasett er en viktig praksis som lar forskere bruke avidentifiserte helsedata til analyser samtidig som pasientenes personvern ivaretas. Avanserte teknikker som biomedisinsk semantisk indeksering forbedrer brukervennligheten og nøyaktigheten til medisinske datasett ytterligere, noe som gjør det enklere å organisere og hente relevant informasjon. Ved å prioritere både datakvalitet og sikkerhet kan helseinstitusjoner fremme tillit, støtte samsvar og muliggjøre sikker og effektiv bruk av medisinske datasett til forskning og innovasjon.