Data er supermakten som forvandler det digitale landskapet i dagens verden. Fra e-poster til innlegg på sosiale medier, det er data overalt. Det er sant at bedrifter aldri har hatt tilgang til så mye data, men er det nok å ha tilgang til data? Den rike informasjonskilden blir ubrukelig eller foreldet når den ikke blir behandlet.
Ustrukturert tekst kan være en rik kilde til informasjon, men den vil ikke være nyttig for bedrifter med mindre dataene er organisert, kategorisert og analysert. Ustrukturerte data, som tekst, lyd, videoer og sosiale medier, utgjør 80–90 % av all data. Dessuten er det knapt 18 % av organisasjonene som rapporteres å dra nytte av organisasjonens ustrukturerte data.
Manuell siling gjennom terabyte med data lagret på serverne er en tidkrevende og rett og slett umulig oppgave. Med fremskrittene innen maskinlæring, naturlig språkbehandling og automatisering er det imidlertid mulig å strukturere og analysere tekstdata raskt og effektivt. Det første trinnet i dataanalyse er tekstklassifisering.
Hva er tekstklassifisering?
Tekstklassifisering eller kategorisering er prosessen med å gruppere tekst i forhåndsbestemte kategorier eller klasser. Ved hjelp av denne maskinlæringsmetoden kan all tekst – dokumenter, nettfiler, studier, juridiske dokumenter, medisinske rapporter og mer – klassifiseres, organiseres og struktureres.
Tekstklassifisering er det grunnleggende trinnet i naturlig språkbehandling som har flere bruksområder innen spamdeteksjon. Sentimentanalyse, intensjonsdeteksjon, datamerking og mer.
Tilfeller av mulig bruk av tekstklassifisering

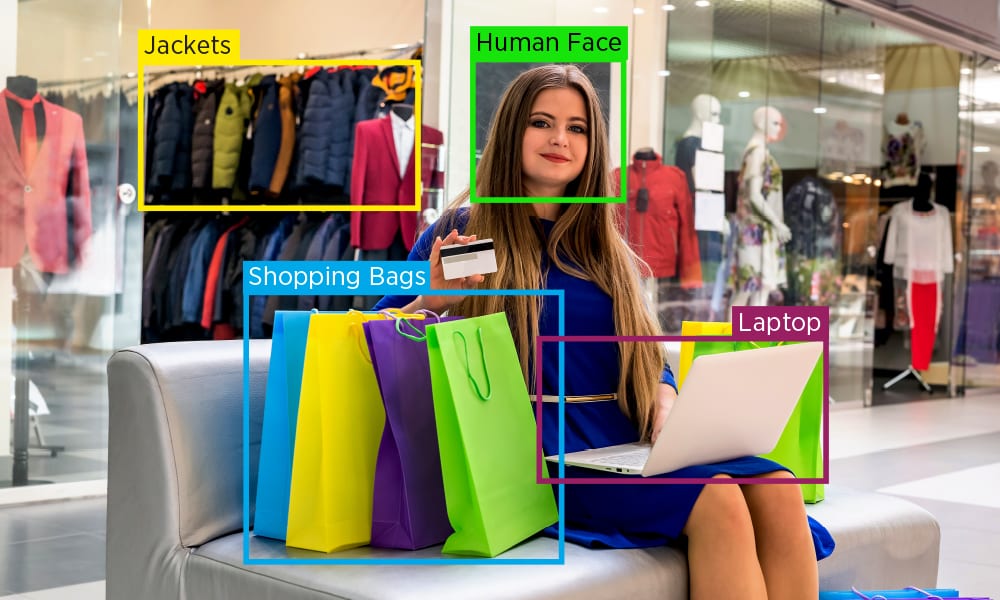
Når ML-modellen er trent på AI som automatisk kategoriserer varer under forhåndsinnstilte kategorier, kan du raskt konvertere tilfeldige nettlesere til kunder.
Tekstklassifiseringsprosess
Tekstklassifiseringsprosessen starter med forhåndsbehandling, funksjonsvalg, utvinning og klassifisering av data.

Forbehandling
Tokenisering: Tekst deles opp i mindre og enklere tekstformer for enkel klassifisering.
Normalisering: All tekst i et dokument må være på samme forståelsesnivå. Noen former for normalisering inkluderer,
- Opprettholde grammatiske eller strukturelle standarder på tvers av teksten, for eksempel fjerning av mellomrom eller tegnsetting. Eller opprettholde små bokstaver gjennom hele teksten.
- Fjerne prefikser og suffikser fra ord og bringe dem tilbake til rotordet.
- Å fjerne stoppord som 'og' 'er' 'den' og flere som ikke tilfører teksten verdi.
Funksjonsvalg
Funksjonsvalg er et grunnleggende trinn i tekstklassifisering. Prosessen er rettet mot å representere tekster med de mest relevante funksjonene. Funksjonsvalg hjelper til med å fjerne irrelevante data og forbedre nøyaktigheten.
Funksjonsvalg reduserer inngangsvariabelen i modellen ved å bruke bare de mest relevante dataene og eliminere støy. Basert på typen løsning du søker, kan AI-modellene dine designes for å velge bare de relevante funksjonene fra teksten.
Funksjonsekstraksjon
Funksjonsutvinning er et valgfritt trinn som enkelte virksomheter tar for å trekke ut flere nøkkelfunksjoner i dataene. Funksjonsutvinning bruker flere teknikker, for eksempel kartlegging, filtrering og gruppering. Den primære fordelen med å bruke funksjonsekstraksjon er – det hjelper til med å fjerne overflødige data og forbedre hastigheten som ML-modellen utvikles med.
Merking av data til forhåndsbestemte kategorier
Merking av tekst til forhåndsdefinerte kategorier er det siste trinnet i tekstklassifisering. Det kan gjøres på tre forskjellige måter,
- Manuell merking
- Regelbasert matching
- Læringsalgoritmer - Læringsalgoritmene kan videre klassifiseres i to kategorier som overvåket tagging og uovervåket tagging.
- Overvåket læring: ML-modellen kan automatisk justere taggene med eksisterende kategoriserte data i overvåket tagging. Når kategoriserte data allerede er tilgjengelige, kan ML-algoritmene kartlegge funksjonen mellom taggene og teksten.
- Uovervåket læring: Det skjer når det er mangel på tidligere eksisterende taggede data. ML-modeller bruker klynging og regelbaserte algoritmer for å gruppere lignende tekster, for eksempel basert på produktkjøpshistorikk, anmeldelser, personlige detaljer og billetter. Disse brede gruppene kan analyseres videre for å trekke verdifull kundespesifikk innsikt som kan brukes til å designe skreddersydde kundetilnærminger.
Tekstklassifisering: Applikasjoner og brukstilfeller
Autonomisering av gruppering eller klassifisering av store biter av tekst eller data gir flere fordeler, noe som gir opphav til distinkte brukstilfeller. La oss se på noen av de vanligste her:
- Spam Deteksjon: Brukes av e-posttjenesteleverandører, telekomtjenesteleverandører og forsvarsapper for å identifisere, filtrere og blokkere søppelpostinnhold
- Sentimentanalyse: Analyser anmeldelser og brukergenerert innhold for underliggende følelser og kontekst og bistå i ORM (Online Reputation Management)
- Hensiktsgjenkjenning: Forstå bedre intensjonen bak forespørsler eller forespørsler fra brukere for å generere nøyaktige og relevante resultater
- Emnemerking: Kategoriser nyhetsartikler eller brukerlagde innlegg etter forhåndsdefinerte emner eller emner
- Språkgjenkjenning: Finn språket en tekst vises eller presenteres på
- Hastighetsdeteksjon: Identifiser og prioriter nødkommunikasjon
- Social Media Monitoring: Automatiser prosessen med å holde øye med omtale av merkevarer i sosiale medier
- Støttebillettkategorisering: Kompiler, organiser og prioriter støttebilletter og serviceforespørsler fra kunder
- Dokumentorganisasjon: Sortere, strukturere og standardisere juridiske og medisinske dokumenter
- E-postfiltrering: Filtrer e-poster basert på spesifikke forhold
- Oppdagelse av svindel: Oppdag og flagg mistenkelige aktiviteter på tvers av transaksjoner
- Markedsundersøkelser: Forstå markedsforhold fra analyser og bistå i bedre posisjonering av produkter og digitale annonser med mer
Hvilke beregninger brukes til å evaluere tekstklassifisering?
Som vi nevnte, er modelloptimalisering uunngåelig for å sikre at modellytelsen din er konsekvent høy. Siden modeller kan støte på tekniske feil og forekomster som hallusinasjoner, er det viktig at de blir bestått gjennom strenge valideringsteknikker før de tas direkte eller presenteres for et testpublikum.
For å gjøre dette kan du bruke en kraftig evalueringsteknikk kalt Cross-Validation.
Kryssvalidering
Dette innebærer å dele opp treningsdata i mindre biter. Hver liten del av treningsdata blir deretter brukt som et eksempel for å trene og validere modellen din. Når du kickstarter prosessen, trener modellen din på den første lille delen av treningsdataene som er gitt og testes mot andre mindre biter. Sluttresultatene av modellytelsen veies opp mot resultatene generert av modellen din trent på brukerkommentarer.
Nøkkelberegninger brukt i kryssvalidering
| Nøyaktighet | Husker | Precision | F1-poengsum |
|---|---|---|---|
| som angir antall riktige spådommer eller resultater generert angående totale spådommer | som angir konsistensen i å forutsi de riktige resultatene sammenlignet med de totale riktige forutsigelsene | som angir modellens evne til å forutsi færre falske positiver | som bestemmer den generelle modellens ytelse ved å beregne det harmoniske gjennomsnittet av gjenkalling og presisjon |
Hvordan utfører du tekstklassifisering?
Selv om det høres skremmende ut, er prosessen med å nærme seg tekstklassifisering systematisk og involverer vanligvis følgende trinn:
- Lag et opplæringsdatasett: Det første trinnet er å kompilere et mangfoldig sett med treningsdata for å bli kjent med og lære modeller å oppdage ord, uttrykk, mønstre og andre sammenhenger autonomt. Dybdetreningsmodeller kan bygges på dette grunnlaget.
- Forbered datasettet: De kompilerte dataene er nå klare. Imidlertid er det fortsatt rått og ustrukturert. Dette trinnet innebærer rengjøring og standardisering av dataene for å gjøre dem maskinklare. Teknikker som annotering og tokenisering følges i denne fasen.
- Trene tekstklassifiseringsmodellen: Når dataene er strukturert, begynner treningsfasen. Modeller lærer av kommenterte data og begynner å lage forbindelser fra de matede datasettene. Etter hvert som mer treningsdata mates inn i modeller, lærer de bedre og genererer autonomt optimaliserte resultater som er tilpasset deres grunnleggende intensjoner.
- Evaluer og optimaliser: Det siste trinnet er evalueringen, der du sammenligner resultatene generert av modellene dine med forhåndsidentifiserte beregninger og benchmarks. Basert på resultater og konklusjoner, kan du ta en samtale om hvorvidt mer opplæring er involvert eller om modellen er klar for neste trinn av distribusjon.
Det er ikke lett å utvikle et effektivt og innsiktsfullt tekstklassifiseringsverktøy. Med Shaip som din datapartner kan du likevel utvikle et effektivt, skalerbart og kostnadseffektivt AI-basert tekstklassifiseringsverktøy. Vi har tonnevis av nøyaktig kommenterte og bruksklare datasett som kan tilpasses modellens unike krav. Vi gjør teksten din til et konkurransefortrinn; ta kontakt i dag.